
第3章 戦略設計を自動化する
URL からのブランドナレッジづくり、3C 分析から訴求の設計、媒体の選定、競合とトレンドの定点観測、検証と定例まで、マーケティングの戦略設計をAI エージェントで自動化する手順を解説します。
この章で学ぶこと
- 事業の定義を「ブランドナレッジ」と「カスタム指示」に分けて AI に渡す方法
- 3C 分析・N1 分析・業界の数字の調べ方・競合調査を Skill にする方法
- 媒体選定の方法
- 判定基準を先に決める実験の進め方と、チャネルを合算しない定例レポートの作り方
- 情報収集の道具を「読むだけ」と「操作できる」に分ける考え方と、RSS や X API を使った定点監視の作り方
事業を分析する
ブランドナレッジと指示を分ける
AI に戦略を考えてもらうためには、まず AI に自社のことを知ってもらう必要があります。そのために用意するのがブランドナレッジです。ブランドナレッジとは、一般に「ブランドガイドライン」や「ブランドブック」と呼ばれる資料に近いもので、「自分たちは何者で、誰に、どんな価値を、どんな口調で届けるか」を 1 か所にまとめたものです。ブランドナレッジを用意しておけば、広告・SNS・Web サイトのどこで発信しても、同じ印象を与えることができます。
ブランドナレッジによく出てくる言葉に「トンマナ」があります。トンマナとは「トーン&マナー」の略で、トーンは色や雰囲気、マナーは様式や言葉づかいのことです。フォントやブランドカラー、写真の明るさ、敬語で話すのかくだけた口調で話すのか、といった「その会社らしさ」の決まりごとを指します。トンマナが揃っていると、見た人が「あの会社だ」とすぐに気づき、記憶に残りやすくなります。
AI Agent に戦略設計を任せるときに最初に渡すべきなのは、3C などの分析のフレームワークではなく、このブランドナレッジです。ブランドナレッジが無いと、AI は実行のたびに事業を一から調べ直すことになってしまいます。一度作っておけば、その後に行うすべてのマーケティング施策に、同じブランドナレッジを前提として反映させることができます。また、ブランドナレッジとは別に、AI に「どう動いてほしいか」を書いたカスタム指示も用意しておきましょう。この 2 つは更新の頻度も書く人も違うので、分けて管理するのがおすすめです。
| 種類 | 中身 | 更新の頻度 | 書く人 |
|---|---|---|---|
| ブランドナレッジ(事業の定義) | 事業の 1〜2 文の説明、主要ターゲット、提供価値・強み、トンマナ、表記の正、禁止表現 | 最初に固まり、以後は稀 | 事業を知っている人(オーナー) |
| カスタム指示(どう動いてほしいか) | レポートの決まった構成、毎回やってほしい確認、言ってはいけないこと、締めの定型文 | 運用しながら増える | 運用している人(担当者) |
自社の Web サイトがあれば、ブランドナレッジやトンマナに必要な情報の大半はサイトから得ることができます。例えば、以下のような Skill を用意しておけば、自社の URL を渡すだけでブランドナレッジを作成できます。
---
name: brand-knowledge-from-url
description: 会社やサービスのサイト URL から、ブランドナレッジ(事業・主要ターゲット・提供価値・トンマナ)を作る。「URL からブランドの前提を整理して」「このサイトの事業をまとめて」で使う。
---

# URL からブランドナレッジを作る

## 目的

サイトを読んで、そのブランドについて「何者か」を短くまとめる。
できあがったものは、以降の企画・執筆・分析で毎回の前提として使い回す。
**推測ではなく、サイトに書いてあることだけ** で作る。

## 手順

1. トップページを読む。
2. 主要な下層ページを読む。会社概要・サービス(商品)・料金・事例・よくある質問など。
   ナビゲーションやフッターから辿れるものを優先する。
3. 読んだ内容から、次の 4 項目をそれぞれ 1 文で書く。

   | 項目 | 書くこと |
   |---|---|
   | 事業 | 誰に、何を売っているか |
   | 主要ターゲット | 主に想定している顧客像(属性・利用シーン) |
   | 提供価値・強み | 顧客がこのブランドを選ぶ理由として、サイトが打ち出しているもの |
   | トンマナ | サイトの文章から読み取れる話し方やデザインや配色など |

4. あわせて、次のことも整理して本文に書く
   - 収益モデル(何にお金を払ってもらうか)
   - 購買までの導線(問い合わせ・予約・購入がどこで起きるか)
   - いま使っている集客チャネルと、そこで何を訴求しているか

## 守ること

- **事実だけを書く。** 「〜が弱い」「〜すべき」といった課題・所見・提案は、
  ブランドナレッジではなく別の節(所見)に分けて書く。前提に混ざると、
  以降の作業がその評価を事実として扱ってしまう。
- **注記を混ぜない。** 「【推定】〜」「おそらく〜」は書かない。
  サイトから確認できない項目は空欄にして、「確認できなかった」と別に書く。
  推測を書くと、それが前提として使い回され続ける。
- **数字・実績・資格は、サイトに書かれている表現のまま写す。** 丸めたり言い換えたりしない。
この Skill を最初に 1 回だけ実行してブランドナレッジを作っておき、以降の企画・執筆・分析では、毎回それを前提として AI に渡します。
ただし、気をつけないといけないのは、ブランドナレッジに AI の推測が混じってしまうことです。前提に推測が混じると、その後のすべての成果物で推測が事実として扱われ、どこで間違えたのかを誰も辿れなくなってしまいます。そのため、この Skill では、サイトから確認できない項目は空欄にして「確認できなかった」と別に書かせるようにしています。こうしておけば、足りない情報はその情報を知っている人が後から足すことができます。また、「〜が弱い」といった所見や提案を別の節に分けさせているのも同じ理由で、評価が前提に混ざると、以降の作業でそれが事実として扱われてしまうからです。
3C(顧客・競合・自社)
3C 分析は、経営コンサルタントの大前研一氏が提唱したことで知られる、マーケティング戦略の定番の枠組みです。「市場・顧客(Customer)」「競合(Competitor)」「自社(Company)」の頭文字を取っています。3 つを別々に調べること自体が目的ではありません。「顧客が求めていて、競合が満たせておらず、自社なら応えられること」を見つけるのが目的で、これを KSF(Key Success Factor=勝つための条件)と呼びます。
よく一緒に使われるのが SWOT 分析です。自社の強み(Strengths)・弱み(Weaknesses)と、外部の機会(Opportunities)・脅威(Threats)を 4 つのマスに整理します。3C が「市場の構造を理解する」ための枠組みなのに対し、SWOT は「自社の戦略を立てる」ための枠組みです。3C で集めた事実を SWOT に並べ直し、「強み × 機会」のように掛け合わせて打ち手の候補を出します(クロス SWOT)。
参考: 3C分析とは(博報堂アイ・スタジオ)、3C分析とSWOT分析の違い(reiro)
うちの旅館の 3C 分析をしてください。これだけだと、AI は一般論を返して終わってしまいます。目的が書かれていないので、勝つ条件を絞る基準がありません。読み手も決まっていないので、専門用語の多い資料になってしまいます。そのため、目的や読み手を定義して、以下のようなプロンプトを AI に渡してあげることで、より事業のヒントになる情報を得ることができます。
温泉旅館「湯守の宿」(客室 18 室、山あいの温泉地)の 3C 分析をしてください。
目的: 平日の個人客の予約を増やすために、広告の訴求と媒体の方向を決めること。
読み手: 旅館のオーナー。広告の専門用語は分かりません。

進め方:
- 公式サイト・予約サイトの掲載・口コミ・自治体の観光統計は、質問する前に調べてください。
  調べても分からない前提は「仮定」と書いて進めてください。
- 顧客は 2〜3 の人物像に分け、それぞれ「予約するときに重視する理由」を重要な順に並べてください。
- 競合は同じ温泉地の旅館だけでなく、予約サイト、近くの日帰り温泉、旅の発信者まで含めてください。
- 最後に「誰に・何を・なぜ(なぜ今まで泊まらなかったか)・どう」を 1 つの表にまとめてください。
  「なぜ今まで泊まらなかったか」は、あとで特典や保証を設計する材料に使います。

出力:
- 数字や表には「出典・使ったデータ・公表日・URL」を付けてください。

しないこと: インタビューをしていない顧客の声を書かない。出典の無い数字を書かない。
案件が変わるたびに上記のようなプロンプトを用意するのが面倒な場合は、3C 分析を Skill に落とし込んでおくことで、毎回精度の高い 3C 分析を行うことができます。
もっと詳しく: 実際に著者が利用している 3C 分析の Skill を添付したので参考にしてください
目的
プロンプトと同様に、まずは目的を定義しています。また、他の類似する Skill と役割が重複しないように、description に案内を書いています。
---
name: market-position-analysis
description: >-
  商材の 3C 分析(Customer/Competitor/Company)から SWOT・KBF・KSF・ポジショニングマップ・WHO/WHAT/WHY/HOW の訴求軸まで落とす。「3C 分析」「SWOT 分析」「競合 SWOT」「市場分析」「顧客分析」「ポジショニング」「訴求軸を整理」「この商材の勝ち筋」で使う。※媒体選定は media-selection、顧客 1 人の深掘りは single-customer-deep-dive、競合の継続的な差分監視は competitor-watch。
---

# 市場・競合・自社の整理(3C 分析 → 訴求設計)

## スキルの目的

従来の 3C 分析は「フレームを埋める」ことがゴールになりがちだが、本スキルは **広告・SNS の訴求軸・媒体選定・クリエイティブ企画に直接接続できる粒度**で 3C を実施する。
手順1〜2: 対象の確認と情報収集
## ワークフロー

### Step 1: 対象と前提条件の確認

ユーザーに以下を確認(既に提示されている場合はスキップ):

1. **対象企業/商材**の名称
2. **目的**(顕在リード獲得 / 認知拡大 / ブランディング / 特定層獲得 等)
3. **KGI/予算感**(わかれば)
4. **既知の差別化ポイント**(わかれば)
5. **エリア・対象市場**

不明点があれば `AskUserQuestion` で確認。ただし **Web 調査で解決できることは先に調査してわからない場合にAskUserQuestionを使う**。

### Step 2: 情報収集

以下の情報源から体系的に収集:

| 情報源 | 取得内容 |
|---|---|
| 公式サイト(ページ取得ツール = WebFetch 等) | 事業内容・MVV・会社概要・サービス詳細・料金・実績・代表者 |
| 求人サイト | 企業文化・従業員数・給与・社風・口コミ |
| 企業データベース・人事系メディア | 資本金・沿革・関連会社 |
| Web 検索ツール | 業界ランキング・シェア・競合比較・オーナー/顧客アンケート・市場調査 |
| 競合公式サイト | 主要競合 3-5 社の料金・訴求・強み |
| 業界団体・統計 | 市場規模・成長率 |
| ニュース・プレスリリース | 最新動向・新サービス |

不明点があれば `AskUserQuestion` で確認。ただし **Web 調査で解決できることは先に調査してわからない場合にAskUserQuestionを使う**。

**統計収集は「国→自治体→エリア→個店」の 4 段階解像度で階層的に積む**(マクロからミクロへ)。業界大手の予測・速報値は政府統計の確定値より早く出るため「先行指標」として先取りし、後から出る確定統計と整合性をチェックする一文を添える。ベンチマーク対象(比較企業・比較エリア・比較事例)は「類似業態×類似立地×先行事例」の 3 条件で選び、選定理由を明文化する。

**すべての表・数値に出典(ソース×活用データ×公表日)を紐付ける**。一次情報(政府統計・IR 等)と二次情報(取材記事・業界メディア等)を混在させる場合は二次側に但し書きを付ける。出典に辿れない数字は使わず「未取得」と書く。詳細は同ファイル §2 参照。
Step1 は前節で説明したブランドナレッジが用意されていれば、スキップすることができます。
AskUserQuestion は、Claude が作業の途中でユーザーに選択式の質問を出すためのツールです。第二章で縮退の重要性について説明しましたが、分析系の Skill でもユーザーしか持っていない情報を無理に AI が推測で埋めてしまうことを避けるために、要所で言及します。
業界大手の情報や国単位の情報は Web 上にあることが多いですが、解像度が低く、必ずしも自分の事業に関連する情報とは限りません。逆にエリアや個店ごとの情報は、自分の事業に直結する情報であることが多いですが、Web 上にはないことがほとんどです。そのため、マクロからミクロへ段階的に情報を収集させます。
また、業界大手の速報値を先行指標として使わせているのは、政府の確定統計が出るのは数ヶ月後になることが多く、それを待っていては資料の作成に間に合わないからです。ただし、後から出た確定値と整合しているかを確かめる一文は必ず添えさせています。速報値だけで書いた資料は、後から出た確定値と食い違ったときに、その数字だけでなく資料全体の信頼性が疑われてしまうからです。
手順 3: 顧客
### Step 3: Customer(顧客)分析

#### 3-1. 市場・対象の規模と属性
- 市場規模(TAM)
- ターゲットセグメントのボリューム(SAM、SOM)
- 主要デモグラ(年齢・性別・職業・所得・居住エリア・家族構成)
- 主要サイコグラ(価値観・趣味・悩み)

#### 3-2. セグメント細分化(必ず複数ペルソナ化)
対象顧客を**最低 2-3 ペルソナ**に分割し、それぞれ:
- ペルソナ名(例:「乗り換え検討層」「新規参入層」「継続利用層」)
- 年齢・属性・状況
- 悩み・不満・不安
- 検討トリガー
- KBF 上位 3-5(重要購買要因)
- LTV 構造(単発 / 継続 / 紹介)

#### 3-3. KBF(Key Buying Factor)の抽出
**ペルソナ共通の重要購買要因**を 5-7 個挙げ、重要度順にランク付け。
可能ならアンケート調査等の**数値データで裏付ける**。

**数値は 6 技法で説得力に変換してから提示する**:①クライアントの KGI/中計との差分を定量化するギャップ変換 ②絶対値でなく倍率で見せる ③単年でなく複数年の傾きで構造変化を語る ④投資額をクライアントの規模感で相対化 ⑤逆風データを自案の妥当性の証拠に反転させる危機感/安心感セット ⑥リサーチ日と資料使用日にズレがある場合の旧→新差し替え表。

#### 3-4. 検討プロセス(カスタマージャーニー)
- 認知 → 興味 → 情報収集 → 比較 → 決定 → 利用 → 継続/紹介
- 各段階での情報チャネル・不安・離脱要因を特定

#### 3-5. Customer Summary(1 段落)
「この市場は〇〇な特徴があり、当社のターゲット層は〇〇。最重要 KBF は〇〇で、〇〇なタイミングで検討が始まる」
手順 4: 競合
AI に「競合」とだけ頼むと、同業他社の一覧が返ってくるだけです。しかし実際には、予約サイトや個人の発信者なども、顧客の予算と時間を奪い合う競合になります。こうした競合は、依頼文に書かない限り AI の調査の範囲に入りません。そのため、著者の会社では、①直接競合 ②EC 競合 ③チャネル代替 ④顧客側プラットフォーム ⑤個人発信者(コンテンツ競合)の5階層で競合を分析しています。
### Step 4: Competitor(競合)分析

**競合は「直接競合」だけでなく 5 階層で見る**:①直接競合 ②EC 競合 ③チャネル代替 ④顧客側プラットフォーム ⑤個人発信者(コンテンツ競合)。各階層の表に「対クライアント」列を置き、必ず自社視点の含意に 1 行で変換する。加えて自社/クライアントの SNS 運用状況をプラットフォーム別に◯△✕で評価し、✕(空白)は弱みでなく先行者利益を取れる財産として扱う。詳細は `references/market-research-techniques.md` §4・§5 参照。

#### 4-1. 競合マップ(2-3 軸)
2 軸または 3 軸の競合マップを作成し、各社をプロット。
軸例:
- 価格帯 × サービス品質
- 大手 × 地域密着
- 機能特化 × ワンストップ
- 低価格訴求 × 信頼訴求

#### 4-2. 主要競合 3-5 社の詳細分析
各競合について:
- 会社概要(規模・歴史・エリア)
- ポジショニング
- 主要訴求メッセージ
- 料金体系
- 強み・弱み(公開情報で確かめた事実だけ。推測には「仮説」と印を付ける)
- 広告クリエイティブの傾向(各媒体の広告ライブラリを人がブラウザで開いて見た内容を記録する。手順は ad-library-research)
- LP 構造

#### 4-3. 競合別 空きポジション特定
競合マップから**差別化の余地(誰もやっていない領域)**を抽出。
5 階層分析と SNS◯△✕マップで洗い出した✕領域を合流させ、**Whitespace(競合空白領域)として番号付きで列挙**する(目安 5-7 個)。番号付きにするのは、Step 6-7 の戦略絞り込みで個別に採否判断するため。

#### 4-4. Competitor Summary(1 段落)
「業界は〇〇という構造で、主要プレイヤーは〇〇。共通して〇〇訴求が多く、〇〇の訴求軸には空きがある」
手順 5: 自社の分析/SWOTへのたたみ込み
同じように、AI に「強み」とだけ聞くと、商品やサービスの良さしか返ってきません。そのため、著者の会社ではサービス力・オペレーション力・ブランド・集客力の 4 つに分けて強みを分析させています。
### Step 5: Company(自社)分析

#### 5-1. 基本情報
- 会社概要・沿革・規模
- MVV(Mission/Vision/Value)
- 事業内容・サービスライン
- 代表者・経営体制

#### 5-2. 強みの 4 レイヤー分析
| レイヤー | 抽出観点 |
|---|---|
| サービス力 | 提供価値・品質・独自機能・対応力 |
| オペレーション力 | スピード・柔軟性・内製比率・組織 |
| ブランド・信頼 | 歴史・実績・認定・権威 |
| 集客・データ | 既存顧客数・LTV・紹介率・チャネル多様性 |

#### 5-3. 既存の訴求資産を棚卸し
- 公式サイトの既存キャッチコピー
- オーナー/顧客の声・事例
- 代表・社員の顔出し素材
- 動画・写真アセット
- ブランドカラー・世界観

#### 5-4. Company Summary(1 段落)
「自社は〇〇という強みを持ち、〇〇な独自性がある。既存の訴求は〇〇で、〇〇という素材がある」

#### 5-5: SWOT への畳み込み(依頼が SWOT のときは必須、それ以外は任意)
3C の材料を SWOT マトリクス(強み/弱み=自社内部、機会/脅威=外部環境)に畳む。
新しい調査はしない——**Step 3〜5 で出た事実の並べ直し**であり、根拠の無い項目を
足さない(各セルの項目に出典を紐付ける)。クロス SWOT(強み×機会=伸ばす一手、
弱み×脅威=守る一手)まで出すと、そのまま KSF(Step 6)の候補になる。
手順 6〜7: 勝つ条件とポジショニング
勝つ条件(KSF)は 3〜5 個に絞り、経営課題への直結度・競合の空白の大きさ・自社のアセットとの相性の 3 つの観点をすべて満たすものを優先させています。絞る基準が無いと、3C で見つかった空白がすべて「打ち手」として並んでしまい、どれから始めればいいか分からなくなってしまうからです。
### Step 6: KSF(Key Success Factor)の抽出

3C 分析の結果から、**この市場で勝つための成功要因**を 3-5 個抽出。
医療脱毛クリニックの例:「経営理念」「人材育成」「医療 DX」「マーケティング」の 4 点で整理するパターンを参考に。

自社が KSF のどれを満たしているか/いないかを評価し、**伸ばすべき軸を特定**。

**KSF 候補・戦略候補は「経営課題への直結度×Whitespace の大きさ×自社アセット適合」の 3 レンズの重なりで絞り込む**。3 つとも満たす候補を優先し、1-2 個しか満たさない候補は「後回し/捨てる」として理由つきで明示する(理由に次回提案・追加提案への布石を込めてよい)。各候補には必ず定量 KPI を仮置きする。詳細は `references/market-research-techniques.md` §6 参照。

### Step 7: ポジショニング決定

#### 7-1. ポジショニングマップ上の自社位置
- 競合マップ(Step 4-1)に自社をプロット
- **空きポジション**か、既存位置での再定義か明示

#### 7-2. 差別化メッセージを 1 行で
「◯◯(競合 A)と◯◯(競合 B)の中間で、◯◯という独自価値を提供」形式で。
例:
- 医療脱毛クリニックの例:「低価格エステ脱毛と高価格美容クリニックの中間で、中価格×医療品質×安心保証」
- 賃貸管理会社の例:「大手画一管理と地場個人商店の中間で、中規模×マッチング重視×堅実運用」
手順 8: WHO → WHAT → WHY → HOW
マーケティングエンジニアにとって、3C 分析のゴールは「マーケティングの訴求と媒体を決めること」です。手順 7 までにまとめた 3C 分析を WHO → WHAT → WHY → HOW に落とし込むことで、訴求と媒体選定の方向性を AI に考えさせます。
### Step 8: WHO → WHAT → WHY → HOW の訴求設計

**注:標準順は WHO→WHY→WHAT→HOW だが、ユーザー指定や文脈に応じて順序を変更可能。デフォルトは WHO→WHAT→WHY→HOW または WHY→WHO→WHAT→HOW。**

#### 8-1. WHO(誰に)
- 主要ペルソナを 1-3 個に絞り込み、具体化
- 名前・年齢・職業・家族・状況・悩み・1 日のメディア接触
- 広告配信時のオーディエンス設計に直結する粒度で

#### 8-2. WHAT(何を伝えるか)
WHO の KBF と自社の強みが交差する「伝えるべきメッセージ」を**複数列挙**。
- 訴求軸リスト:機能/ストーリー/比較/社会的証明/権威/限定性/共感・問題提起/ユーザー体験
- 各訴求軸について、自社の具体ネタを 1-2 文で

#### 8-3. WHY(なぜ伝えるか / なぜ今まで利用しなかったか)
- WHY には 2 側面ある:
  - **なぜ今まで利用していなかったか**(障壁・リアクタンス):情報不足/不安/満足してた/諦め
  - **なぜ伝えるのか**(メッセージの必然性):市場変化/課題顕在化/新サービス投入
- 障壁を**広告で解消する設計**につなげる(障壁はオファー設計のスキル(第 4 章)で特典・保証の型を選ぶ材料になる)

#### 8-4. HOW(どう伝えるか)
- クリエイティブ形式(動画 15 秒 / 長尺 YouTube / カルーセル / 記事 LP / 静止画)
- 配信媒体候補(Meta / YouTube / TikTok / リスティング / Yahoo! 等。絞り込みは media-selection)
- LP の形式(直 LP / 2 段階 / エリア選択フォーム 等)
顧客分析とペルソナ
AI を使って顧客アンケートを分析する
アンケートの回答データには、第二章で説明した「構造化データと非構造データ」が、1 つのファイルに混ざっています。選択式の設問の回答は構造化データで、自由記述の回答は非構造化データです。扱い方が違うので、AI に渡すときも分けて指示する必要があります。
- 構造化データ
LLM が表を目で見て平均やクロス集計を出すと、数字を間違えることがあります。そこで、AI には分析軸の提案やレポートの設計だけを頼み、計算は Claude Code にコードを書かせて行います。
- 非構造化データ
自由記述を分析するためには、結果をカテゴリーに分類する必要があります。これまでは人でしか読めなかった領域ですが、AI を使うことで簡単に分類できるようになりました。自由記述 → AIでタグ付け(テーマ・感情) → 回答者IDで評価・属性と結合 → 統計分析 という流れで分析することで、構造化データと非構造化データを結合することができます。これにより、「何%が不満か」(構造化データ)と「なぜ不満か」(非構造化データ)が一つの分析につながり、改善施策の優先順位まで落とし込めるようになります。
また、N1 分析などの、アンケート分析自体のフレームワークも Skill にすることで、より高度なアンケート分析が可能になります。
もっと詳しく: N1 分析とは
N1 分析は、元 P&G のマーケターである西口一希氏が著書『たった一人の分析から事業は成長する 実践 顧客起点マーケティング』で広めた手法です。「N」は調査の人数のことで、N1 は「実在する顧客 1 人」を指します。何百人ものアンケートの平均ではなく、実際に買ってくれた 1 人に深く話を聞き、「なぜ買ったのか」から新しいアイデアを見つけます。その中で、顧客を「顧客ピラミッド(5 セグマップ)」と、それに「次も買いたいか」を掛けて 9 つに分ける「9 セグマップ」に分類します。
| セグメント | 定義 |
|---|---|
| ① ロイヤル顧客 | 認知あり・購買あり・購買頻度が高い |
| ② 一般顧客 | 認知あり・購買あり・購買頻度は低〜中 |
| ③ 離反顧客 | 認知あり・過去に購買あり・今は買っていない |
| ④ 認知・未購買顧客 | 認知あり・一度も買ったことがない |
| ⑤ 未認知顧客 | ブランドを知らない |
| 次も買いたい(積極) | 次は分からない/他でもいい(消極) | |
|---|---|---|
| ロイヤル | 積極ロイヤル:ブランドの熱心な支持者 | 消極ロイヤル:習慣・惰性で買っている。競合が来ると流出しやすい |
| 一般 | 積極一般:ロイヤル化の伸びしろ | 消極一般:たまたま買っている層 |
| 離反 | 積極離反:好きだが事情で離れた。戻しやすい | 消極離反:不満や関心低下で離れた |
| 認知・未購買 | 積極認知未購買:買いたいのに買っていない。障壁の除去で転換 | 消極認知未購買:知っているが魅力を感じていない |
| 未認知 | 未認知(1セグ) |
ペルソナ
ペルソナは、年齢・職業・家族構成・価値観・ふだんの行動まで設定した「実在しそうな 1 人の顧客像」のことです。「30 代女性」のような大まかな対象(ターゲット)より具体的なので、チームの中で「誰に向けて作るか」がぶれにくくなります。N1 が「実在する 1 人」なのに対し、ペルソナは「想定した 1 人」です。
マーケティングでは、ペルソナを考える際に、顧客を切り分ける軸を伝統的に4つに分けます。
- ジオグラフィック(地理的変数):国・地域・都市規模・気候・商圏など
- デモグラフィック(人口統計的変数):年齢・性別・所得・職業・家族構成など
- サイコグラフィック(心理的変数):価値観・ライフスタイル・趣味・性格
- ビヘイビアル(行動変数):購買頻度・利用シーン・ロイヤルティ・検索や閲覧の行動
AI を使ってペルソナをシミュレーションする
従来のペルソナは、担当者の経験や少数のインタビューをもとに「想像で」作ることが多く、思い込みが入りやすいという弱点がありました。AIを使うと、以下の3つのことが可能になります。
- 実データからのクラスタリング
予約データ、GA4、SNSインサイト(国・地域別のフォロワー、年齢層)、口コミなどをもとに、機械的に顧客グループを抽出できます。 - テキストからの心理・行動の抽出
口コミ、SNSのコメント、問い合わせ文をLLMで読ませると、「なぜ選んだか」「何に不満を持ったか」といったサイコグラフィックな要素を大量に抽出できます。 - 合成ペルソナ(シンセティック・ペルソナ)
LLMにペルソナを演じさせ、キャッチコピーや企画への反応を仮説検証することができます。例えば、下記のようなプロンプトで、ペルソナへの仮説検証をすることができます。javascriptあなたは以下の人物です。この人物として、一人称で率直に答えてください。 回答は「本人の感覚」を優先し、模範解答やマーケター目線の分析はしないでください。 - 台湾・台北在住、29歳女性、IT企業勤務 - 訪日は6回目。東京・大阪は行き尽くし、今回は地方の温泉を検討中 - 予算は1泊2万円前後。友人と2人旅 - 情報源はInstagramとThreads、最終的な予約はAgodaが多い - 写真映えより「現地の人っぽい体験」を重視。ただし日本語はほぼ話せない 【質問】 次のリール動画の冒頭3秒を見て、続きを見たいと思いますか? 理由と、予約まで進むために足りない情報を教えてください。 (動画の説明:…)
ジオグラフィックやデモグラフィックの情報は、国の統計データなどをはじめ、ネット上から取得できることが多いですが、サイコグラフィックやビヘイビアルの情報はネット上にないことが多いです。もちろん、サイコグラフィックやビヘイビアルなデータを LLM によって生成させることもできますが、あくまで AI の推測なので、現実とは大きく異なるペルソナを作り出してしまうこともあります。社内にある、サイコグラフィックやビヘイビアルなデータを蓄積し、それを活用できる状態にしておくことが大切です。
競合調査を自動化する
競合分析は、同じお客さんを取り合う相手を特定し、その商品・価格・宣伝のしかた・Web サイトや SNS での発信を調べることです。目的は相手を真似することではなく、「相手が顧客に何を約束しているか」「自社との違いはどこか」「まだ誰も応えていない顧客の要望(空白)はどこか」を知ることにあります。競合の状況は変わり続けるので、一度調べて終わりにせず、同じ項目を定期的に見直すこと(定点観測)が大切です。
定点観測
定点観測は、毎週や毎月の頻度で AI Agent に競合調査を依頼するだけで始めることができます。しかし、ただ依頼するだけでは、前回から何が変わったのかが分からなくなってしまいます。そのため、以下の 3 つに気をつけて定点観測を行ってください。
- 履歴を残しておく
差分を出すためには、前回の結果が必要です。しかし、AI は前回の作業の中身を覚えていません。手元の Claude Code で動かす場合は、案件のフォルダに日付を付けて結果を保存するように指示しておきましょう。
- 見る項目を固定する
見る項目が作業ごとに変わってしまうと、前回と比べることができません。ただし、毎回すべての項目を見る必要はありません。競い合っている顧客や商品に関係する項目から順に見て、見なかった項目はレポートに「今回は対象外」、見ようとしたけれど開けなかった項目は「未取得」と書かせるようにしましょう。何も書かずに省いてしまうと、次に読む人には「変化が無かった」のか「見ていない」のかが区別できなくなってしまいます。著者は見る項目を次の 6 つに固定しています。
監視項目 取り方 差分で読むこと サイト・料金ページ 主要 URL の本文を取得し、前回保存した本文と突き合わせる 値上げ・値下げ、訴求の変更、新メニュー ニュース・PR 期間を指定した Web 検索、プレスリリースの RSS 拡大か撤退か 採用 採用ページ・求人媒体の公開面(職種・拠点・件数) どこに投資しているか 広告 次の「競合の広告の調査」の記録表 新しいクリエイティブ、遷移先の変更 SNS 人が画面で見て記録する、または公式 API 運用の強化・放置、伸びた企画 口コミ 口コミサイト・Google マップの公開面。低評価の本文を重点的に読む 繰り返される不満 = 自社の差別化の余地 - 取得経路を揃える
同じ項目でも、取り方が変わると値の意味が変わってしまいます。例えば、広告の配信本数を前回は人が広告ライブラリで数え、今回は商用サービスの推定値で出したとします。この場合、数字に差が出ても、競合が動いたのか数え方が変わったのかを判断することができません。
競合の広告の調査について
競合がいま配信している広告は、Meta の広告ライブラリや Google 広告の透明性センター、TikTok Creative Center で誰でも見ることができます。ただし、この調査は自動化できる範囲が限られているので注意が必要です。
特に Meta の広告ライブラリの API は、執筆時点では日本の商用広告を取得することができません。また、第一章で説明したように、スクレイピングやブラウザの自動操作による画面の自動収集は、Meta・Instagram・TikTok の利用規約で禁止されています。そのため、競合の広告を調べる方法は次の 2 つになります。第二章で説明した通り、Skill にする際は縮退先も整理しておきましょう。
打ち手を選び、予算を配分する
各打ち手の特徴について
集客の手段を分ける考え方として広く知られているのが「トリプルメディア」です。お金を払って枠を借りる「ペイドメディア」(広告)、自社で持って運営する「オウンドメディア」(Web サイトやブログ)、消費者の口コミや SNS での言及のように評判として得る「アーンドメディア」の 3 つに分けます。3 つは互いを補う関係で、組み合わせて使うのが効果的とされています。
本書では、集客の打ち手を大きく、広告・検索(SEO と LLMO を含む)・SNS のアカウント運用の 3 つに分けて考えます。この 3 つは、届く相手も、効き始めるまでの期間も、止めたときに残るものも違います。どれが優れているかではなく、いまの目的に合ったものを選ぶことが大切です。
| 広告 | 検索・AI 検索 | アカウント運用 | |
|---|---|---|---|
| 誰に届くか | こちらが選んだ相手に、こちらのタイミングで | いま探している人が、向こうから来る | 興味を持ちそうな人に、媒体が届ける |
| 効きはじめ / 止めたら | その日から / その日に止まる | 3〜6 か月 / しばらく流入は続く | 3〜6 か月 / 投稿は残るが伸びは止まる |
| 残るもの | 勝ちパターン(素材と知見) | ページそのもの | アカウントとフォロワー |
| 向く目的 | いますぐの獲得、仮説の検証 | 継続的な問い合わせ、指名 | 認知、ファンづくり、来店の後押し |
3 つの打ち手は、どれかがどれかの代わりになるものではありません。とはいえ、すべてを同時に始めると、どれも中途半端になってしまいます。最初は目的と成果が必要な時期から 1 つに絞り、徐々に施作を増やしていくのがおすすめです。
| 状況 | まず始めるもの | 次に足すもの |
|---|---|---|
| 今月から予約を増やしたい | 広告(いま探している人に届くものから) | 遷移先ページの改善 → Google マップ |
| 店舗があり、近くの人に来てほしい | Google マップ | たて型動画のアカウント運用 → LINE |
| まだ誰にも知られていない | アカウント運用(TikTok・Instagram) | 反応の良かった内容を広告に転用 |
| 問い合わせを長期で安定させたい | 検索(SEO) | AI 検索向けの基盤整備 |
どの施作を選んだ場合でも、始める前に遷移先のページ(LP)と、クリック数や購入数などを計測する仕組みを整えておきましょう。成果を測る仕組みが無ければ、どの打ち手が効いたのかを判断することができません。
関心度の 3 層と、媒体の選び方
3 つの打ち手や各媒体を同じ条件で比べるためには、「相手がどのくらい購入に近いか」という基準を使うのがおすすめです。マーケティングでは、この基準で顧客を顕在層・準潜在層・潜在層の 3 つに分けて考えます。
| 層 | 状態 | 人数 | 効く打ち手 |
|---|---|---|---|
| 顕在層 | 「◯◯ 予約」で検索している | 少ない | 検索広告、Google マップ、指名検索 |
| 準潜在層 | 迷っている、比べている | 中くらい | 動画広告、SNS 広告、比較・選び方の記事 |
| 潜在層 | その選択肢に気づいていない | 多い | ディスプレイ広告、アカウント運用、認知目的の動画 |
申し込みや予約をゴールにする場合は、準潜在層より上を狙う媒体から始めましょう。潜在層に向けた訴求は、反応が良くても誰が購入につながったのかを追いにくいです。そのため、まずは顕在層で成果の出る訴求を見つけてから、潜在層へ広げていくのが定石です。主な広告媒体の得意なことは以下のとおりです。
| 媒体 | 得意なこと |
|---|---|
| Google 検索広告 | 顕在層。すでに探されている商材。競合が多いとクリック単価が上がる |
| Google ディスプレイ・YouTube | 潜在層に安く広く。ディスプレイで認知 → 検索広告で獲得が定番 |
| Meta(Instagram・Facebook) | 実名基盤で「似た人」を探す精度が高い。ターゲットがはっきりしているとき |
| TikTok | たて型動画で短時間に多くの人へ。見た目で価値が伝わる商材を若い層に |
| LINE ヤフー | 他の SNS に届かない層。年齢層が高い商材、地方・全世代 |
| X | 拡散。話題になりやすい商材。年齢・性別で絞る精度は低い |
実際に AI に媒体選定をお願いしてみる
美容室の集客に一番いい広告媒体を教えてください。この依頼だけでは、AI は 1 つの媒体を推薦して終わってしまうことがほとんどです。目的とする成果(予約なのか、認知なのか)も予算も書かれていないので、推薦の根拠も一般論になってしまいます。そのため、3C 分析のときと同じように、目的・予算・比べ方まで書いて、以下のようなプロンプトを AI に渡しましょう。
駅前の美容室(席数 6、客単価 8,000 円)の広告媒体を選んでください。
目的: 新規客の予約。いまの広告費は 0 円で、来月から月 15 万円まで出せます。
主な客層: 近くで働く 20〜30 代の女性。予約はウェブの予約ページで受けています。

進め方:
1. 誰に・なぜ今まで来なかったか・何を・どう伝えるかを先に整理してから媒体を選ぶ。年齢と性別だけで決めない。
2. 候補を 2〜3 個に絞り、選んだ理由を 1〜2 文で書く。
3. 1 つに決めず、同じ素材・同じ金額・同じ期間で比べる検証の計画にする。
4. 撤退ライン(いくら使って予約が 0 件なら止めるか)を、目標の 1 件あたりの費用の倍数で書く。
5. 利用者数や年齢構成を書くときは、出典と時点を添える。

しないこと: 媒体ごとの管理画面の予約件数を足し合わせた計画にしない。広告の作成や配信はしない。
媒体選定は、1 回選んで終わりではありません。候補を絞り(計画)、同じ素材・同じ金額で配信し(実行)、結果を撤退ラインと比べ(評価)、予算の配分を直す(改善)、という PDCA サイクルを繰り返しながら、成果の出る媒体を見つけていきます。
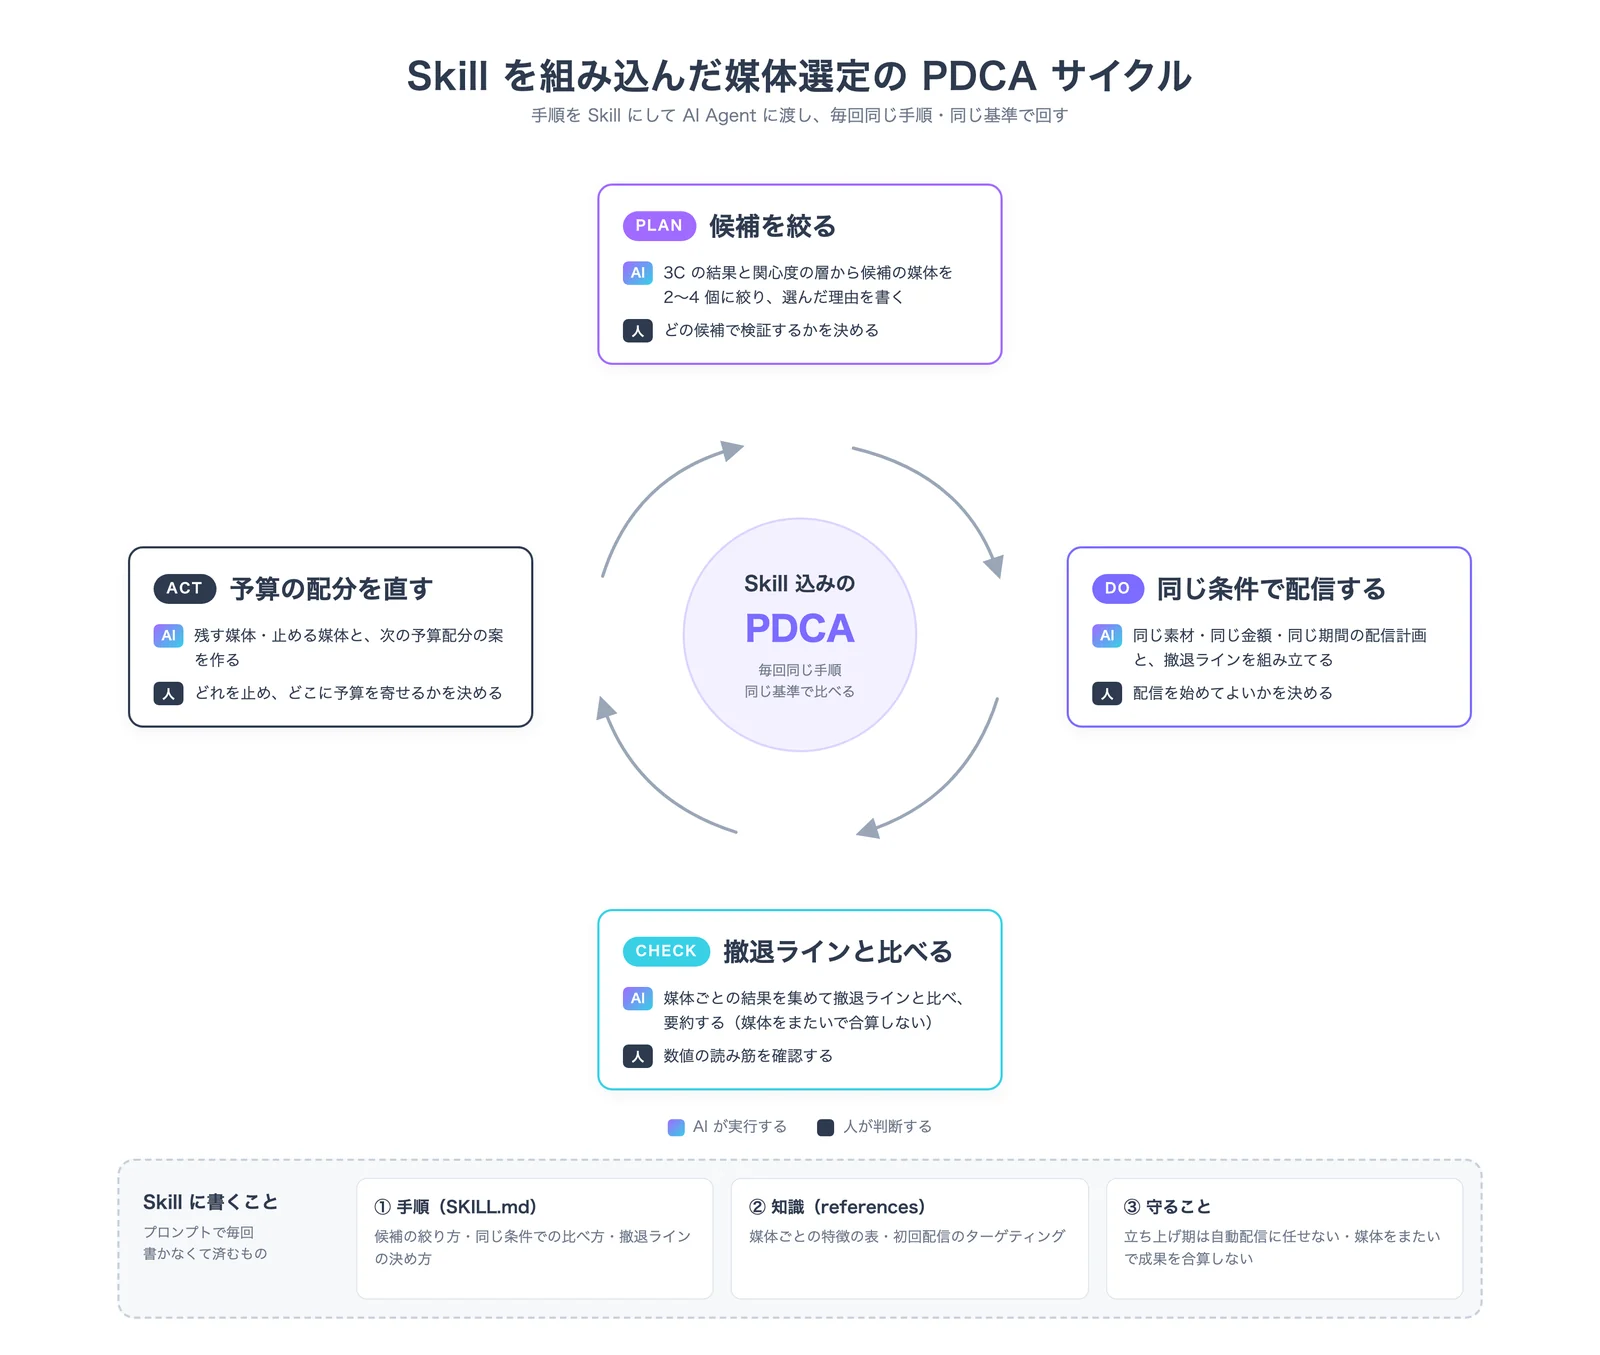
このサイクルを毎回プロンプトだけで指示していると、条件を書き忘れた回だけ比べ方が変わってしまい、前回の結果と比べられなくなります。そのため、PDCA を回し続けるためには、手順を Skill にして AI Agent に組み込んでおくことが大切です。Skill にしておけば、案件が変わっても同じ手順で候補を絞り、同じ基準で結果を比べることができます。
もっと詳しく: 実際に著者が利用している媒体選定の Skill を添付したので参考にしてください
目的
---
name: media-selection
description: >-
  運用型広告の媒体選定。WHO/WHY/WHAT/HOW と関心度層(潜在/準潜在/顕在)で候補を絞り、同一クリエイティブ×同額×同期間の比較検証まで設計する。「広告媒体を選んで」「どの媒体がいい」「Meta・YouTube・TikTok どれがいい」「出稿媒体を決めたい」「予算をどう割るか」で使う。
---

# 媒体を選ぶ

## スキルの目的

運用型広告の成果は媒体選定で大きく左右される。本スキルは「テスト前にどの媒体が適切かを大まかに絞り込む」ためのフレームワークを提供し、絞り込んだ媒体を**同一クリエイティブ・同額・同期間で比較検証する**設計まで導く。媒体は決め打ちせず、最終判断は実測に委ねる。「予算をどう割るか」と聞かれても、このスキルが出すのは候補と比べる計画まで。

## 前提・事業文脈

想定する対象は宿泊施設・飲食店・美容室・自治体等の店舗型ビジネスが多く、CV ゴールは主に「予約」「来店」「応募」。運用の 3 類型(店舗集客型/EC 購買型/採用特化型)のどれに該当するかで、狙うべき関心度層やクリエイティブの作り込み方が変わる。縦型動画を主軸にできる運用体制なら、動画クリエイティブを主軸に据えられる媒体(Meta/YouTube/TikTok)との相性が良い。
手順 1〜2: 前提の整理と WHO/WHY/WHAT/HOW
## ワークフロー

### Step 1: 前提整理

以下をヒアリングまたは既存情報から確認する(既に提示済みならスキップ)。

1. **商材**(サービス内容・提供エリア・価格帯)
2. **CV ゴール**(予約/来店/応募/資料請求/通販購入 等。認知拡大が目的の場合はその旨も明記)
3. **ターゲットの関心度層**: 潜在層/準潜在層/顕在層のどこを狙うか(下の「関心度層と媒体」の判断基準で決め、今回狙う層を 1 つに決める)
4. **デモグラフィック**(性別・年齢分布・居住地域・所得・職業・家族構成)を可能な限り具体化
5. **予算感・審査リスク**(医療・美容医療等、広告審査が厳しい業種かどうか)

不明点は Web 調査や既存資料(顧客情報・過去の成果物等)で埋められる部分は先に埋め、埋まらない前提は Assumption として明示して進める。

#### 関心度層と媒体

| 関心度層 | ユーザー数 | 有効な媒体 |
|---|---|---|
| 潜在層 | 多 | ディスプレイ広告・動画広告・SNS 広告 |
| 準潜在層 | 中 | 動画広告など、視覚的に便益を伝えられる媒体 |
| 顕在層 | 少 | リスティング広告 |

**判断基準**: 申込等がゴールなら準顕在層以上を狙う媒体、認知率向上がゴールなら潜在層向け媒体を選ぶ。

### Step 2: WHO/WHY/WHAT/HOW フレームの整理

次の 4 つを整理する。

- **WHO**: 誰の、どんな悩み・欲求か
- **WHY**: なぜ今まで利用していなかったか(障壁)/なぜ今伝えるのか(メッセージの必然性)
- **WHAT**: 何を伝えるか(サービスの便益・差別化ポイント)
- **HOW**: どう伝えるか(クリエイティブ形式の方向性)

このフレームは `market-position-analysis` スキルの WHO→WHAT→WHY→HOW 訴求設計と対応する。3C 分析が既に実施済みの場合はその出力を流用してよい。年齢と性別だけで媒体を決めない。
手順 1 では、狙う層を 1 つに決めさせています。層を決めないまま媒体を並べると、潜在層向けの媒体と顕在層向けの媒体を同じ予算で比べる計画になってしまい、結果の差が層の差なのか媒体の差なのか分からなくなってしまうからです。また、3C 分析を済ませている場合は、その結果を流用させています。同じ WHO/WHAT/WHY/HOW を 2 度書かせないためです。
手順 3: 媒体の絞り込みと根拠
候補の媒体は 2〜4 個に絞らせています。1 つだけでは比べる相手が無く、逆に多すぎると予算が分散して、どの媒体も自動入札の学習に必要な件数に届かなくなってしまうからです。また、この手順の中には媒体ごとの利用者数の表も置いています。表の先頭には「調査時点の値で、変わる」と断りを入れ、一次出典を確かめていない通説には「数字として載せない」と注記しています。こうしておかないと、古い数字や出典の無い数字が、そのままレポートの根拠として使われてしまうからです。
### Step 3: 媒体の絞り込みと根拠の言語化

下の「主要媒体の特徴」の表と Step 1・2 の結果を照合し、候補媒体を 2〜4 個に絞り込む。

- 各媒体について「なぜこの媒体を選んだか」を 1〜2 文で言語化する(ユーザー数・ユーザー層・関心度対応・フォーマット適性の観点から)
- 利用者数や年齢構成を書くときは出典と時点を添える(表の値は執筆時点の目安。最新の公表値を確かめる)
- 動画クリエイティブが軸になる場合は、下の「動画広告」も踏まえて訴求パターンを検討する
- 審査リスクが高い商材(医療・美容医療等)は、下の「審査が厳しい商材」を確認する
- インフルエンサー広告の公開事例の相場は個別事例。自社の計画の見込み値として転記しない

#### 主要媒体の特徴(抜粋)

表の利用者数・シェアは元資料の調査時点の値で、変わる。

| 媒体 | ユーザー数/シェア | ユーザー層 | ユーザー状態 | こんな時におすすめ |
|---|---|---|---|---|
| Google リスティング | 検索シェア 74.7% | 10 代〜60 代幅広く | 顕在層 | ニーズが顕在化している商材(競合過多は CPC 高騰) |
| Google ディスプレイ | 検索シェア 74.7% | 10 代〜60 代幅広く | 潜在層 | 幅広い層に興味・関心を獲得したい |
| YouTube | MAU 7,120 万人 | 20 代中心、幅広い | すべて対応 | 幅広いユーザーに視覚的に商品をアピールしたい |
| Yahoo!広告 | 検索シェア 8.0% | 30 代〜60 代 | すべて対応 | PC の 40〜50 代/Google に追加して獲得面を拡張 |
| Facebook | 2,600 万人 | 中高年層中心 | すべて対応 | 40〜60 代、詳細ターゲティングが必要 |
| Instagram | 3,300 万人 | 若年層中心 | すべて対応 | 20〜40 代女性、特に美容関連と相性が良い |
| LINE | MAU 9,500 万人 | 偏りなし | すべて対応 | 全国の幅広い層にアプローチしたい |
| X | 7,340 万人 | 10〜40 代 | すべて対応 | リポストで二次拡散が期待できるコンテンツ |
| TikTok | 1,700 万人 | 若年層中心 | すべて対応 | 若年層に視覚的に商品をアピールしたい |

#### 動画広告(動画が軸のときだけ読む)

- 「視覚 87%」のような通説は一次出典を確認していない。レポートに数字として載せない
- 企画は Why → Who → What → How の順。背景・セリフなど撮影後に変えにくい要素は、コンテの段階でパターンを洗い出す

#### 審査が厳しい商材

- 医療・美容医療は審査で落ちやすい。NG 表現を記録し、複数媒体に少額で分散して配信する
手順 4: 検証設計
検証では、同じクリエイティブ・同じ金額・同じ期間で各媒体に配信させています。条件を揃えないと、結果の差が媒体の差なのか予算の差なのかを区別できないからです。また、撤退ライン(いくら使って成果が無ければ止めるか)は出稿前に決めさせています。配信を始めてから決めようとすると、どうしても止める判断が遅れてしまいます。手順の後半には、媒体ごとの初回配信の設定をまとめました。一番大切な原則は「過去データが無い状態で自動ターゲティングから始めない」ことです。媒体の自動最適化は過去の成果データをもとに配信先を選ぶので、新しいアカウントでは、まず手動の設定で成果を貯める必要があります。媒体ごとに項目を分けているので、選んだ候補の媒体の分だけを検証の計画に組み込んでください。
### Step 4: 検証設計

絞り込んだ媒体を一つに決め打ちせず、以下の設計で比較検証する。

1. **同一クリエイティブ×同額×同期間**で各候補媒体に配信し、配信効率を比較する(条件を揃えないと、差が媒体の差なのか予算の差なのか分からない)
2. 媒体ごとの最低出稿額と、自動入札の学習に要る CV 件数を先に置く(分散しすぎてどの媒体も学習しない、を避ける)
3. 審査リスクのある商材は、少額で他媒体の並行検証も継続する(アカウント停止リスクへの分散対応)
4. 商材ごとの目標 CPA・予算から**撤退ライン**を出稿前に設定する。目安は「目標 CPA の約 2 倍を使って CV 0 件なら、その媒体の配信を止めて素材を見直す」。「2 万円以上消化して CV 1 件以下なら撤退」のような金額の例は、商材の目標 CPA で置き直す
5. 検証中は日次〜数時間単位で「継続/設定変更して再出稿/停止」を判断できる体制を確認する
6. 各媒体の**初回配信のターゲティング**は、下の「初回配信の設定」から候補の媒体の分だけを検証プランに織り込む

#### 初回配信の設定

数値・媒体仕様は執筆時点のもの。入稿前に各媒体の公式ヘルプで最新仕様を確認する。

**大原則**

- 過去データがない状態で自動ターゲティングから始めない。新規アカウントの初回配信は手動設定で「低い CPA の CV」をためるのが先
- 効くターゲティングは媒体の強みに沿う: 検索エンジン系(Google/Yahoo!)は検索行動、SNS 系はプロフィール・フォロー関係・投稿ワード、LINE はリーチの広さ

**顕在層 / 潜在層の初手**

| 層 | 全媒体共通 | Google (GDN) | Meta | YDA |
|---|---|---|---|---|
| 顕在層 | LP 訪問者へのリタゲ | コンテンツターゲット(顕在ワード) | 類似オーディエンス 1% | サーチキーワード |
| 潜在層 | 年齢・性別のみ | コンテンツターゲット(ビッグワード) | 類似 5%・興味関心 | 興味関心 |

**媒体ごとの初手**

- GDN: キーワード 5 個程度のコンテンツターゲットから。初期はスマホのアプリ面を除外。「最適化されたターゲティング」は手動検証中はオフ
- YDA: Yahoo 面にプレースメントを絞る。検索広告で CPA が良いキーワードでサーチキーワードターゲティング
- Meta: 類似オーディエンス(ソース 1,000〜50,000 人)。ソースはピクセル由来と顧客リスト由来の複数で試す
- X: 商品名だけでなく口語(「眠れない」等)のキーワードと、関連アカウントのフォロワーターゲティング
- LINE: インプレッションの 9 割超はトークリストと LINE NEWS。Small Image(600×400)は画像か大きな文字のどちらかに振り切る。自動入札には CV 40 件が要る
- P-MAX: 手動の検索+ディスプレイと並行稼働させ、単独に寄せない。目標 CPA は通常キャンペーンより低め

**手動 → 自動入札への移行**

- 移行前: 手動入札で低 CPA の CV をためる
- 移行時: 目標 CPA は手動時代の同額〜2 割引き
- 移行後: 日予算を上限に当てない。目標 CPA の調整は直近 7 日の実績を見て変動 20% 以内
媒体をまたいで効果を測る: MMM
利用する媒体が 2 つ以上になると、来月の予算をどう配分するかを決める必要が出てきます。このとき、各媒体の管理画面の CPA を比べたくなりますが、実はそのままでは比べることができません。管理画面の CV は、各媒体がそれぞれの基準で数えた件数だからです。例えば、Instagram の広告を見て、後日 Google で検索して購入した人は、両方の媒体で 1 件ずつ数えられることがあります。そのため、各媒体の CV を足すと実際の売上より多くなってしまい、比べるとクリックの直前に表示された媒体が実際より良く見えてしまいます。
この問題に対処するための手法が MMM(マーケティング・ミックス・モデリング) です。MMM では、媒体の管理画面の数字ではなく、自社の売上・予約の台帳の週ごとの推移を、媒体別の出稿費・季節性・価格・販促などで回帰分析して、「その媒体が無かったら減っていた売上」を推定します。
本書では詳細な理論については触れませんが、OSS もいくつか公開されているので、AI Agent から呼び出してみるのも面白いかもしれません。
- Meridian(Google・Python)
- Robyn(Meta・R)
- PyMC-Marketing(Python)
打ち手を検証し、定例で振り返る
打ち手を実行したら、それが効いたかどうかを確かめて、次の打ち手に反映させる必要があります。この節では、そのための仕組みを 2 つ紹介します。1 つは個々の打ち手が効いたかを確かめる「実験(A/B テスト)」、もう 1 つは全体としてうまくいっているかを毎月確かめる「定例レポート」です。2 つの関係は以下の図のようになります。
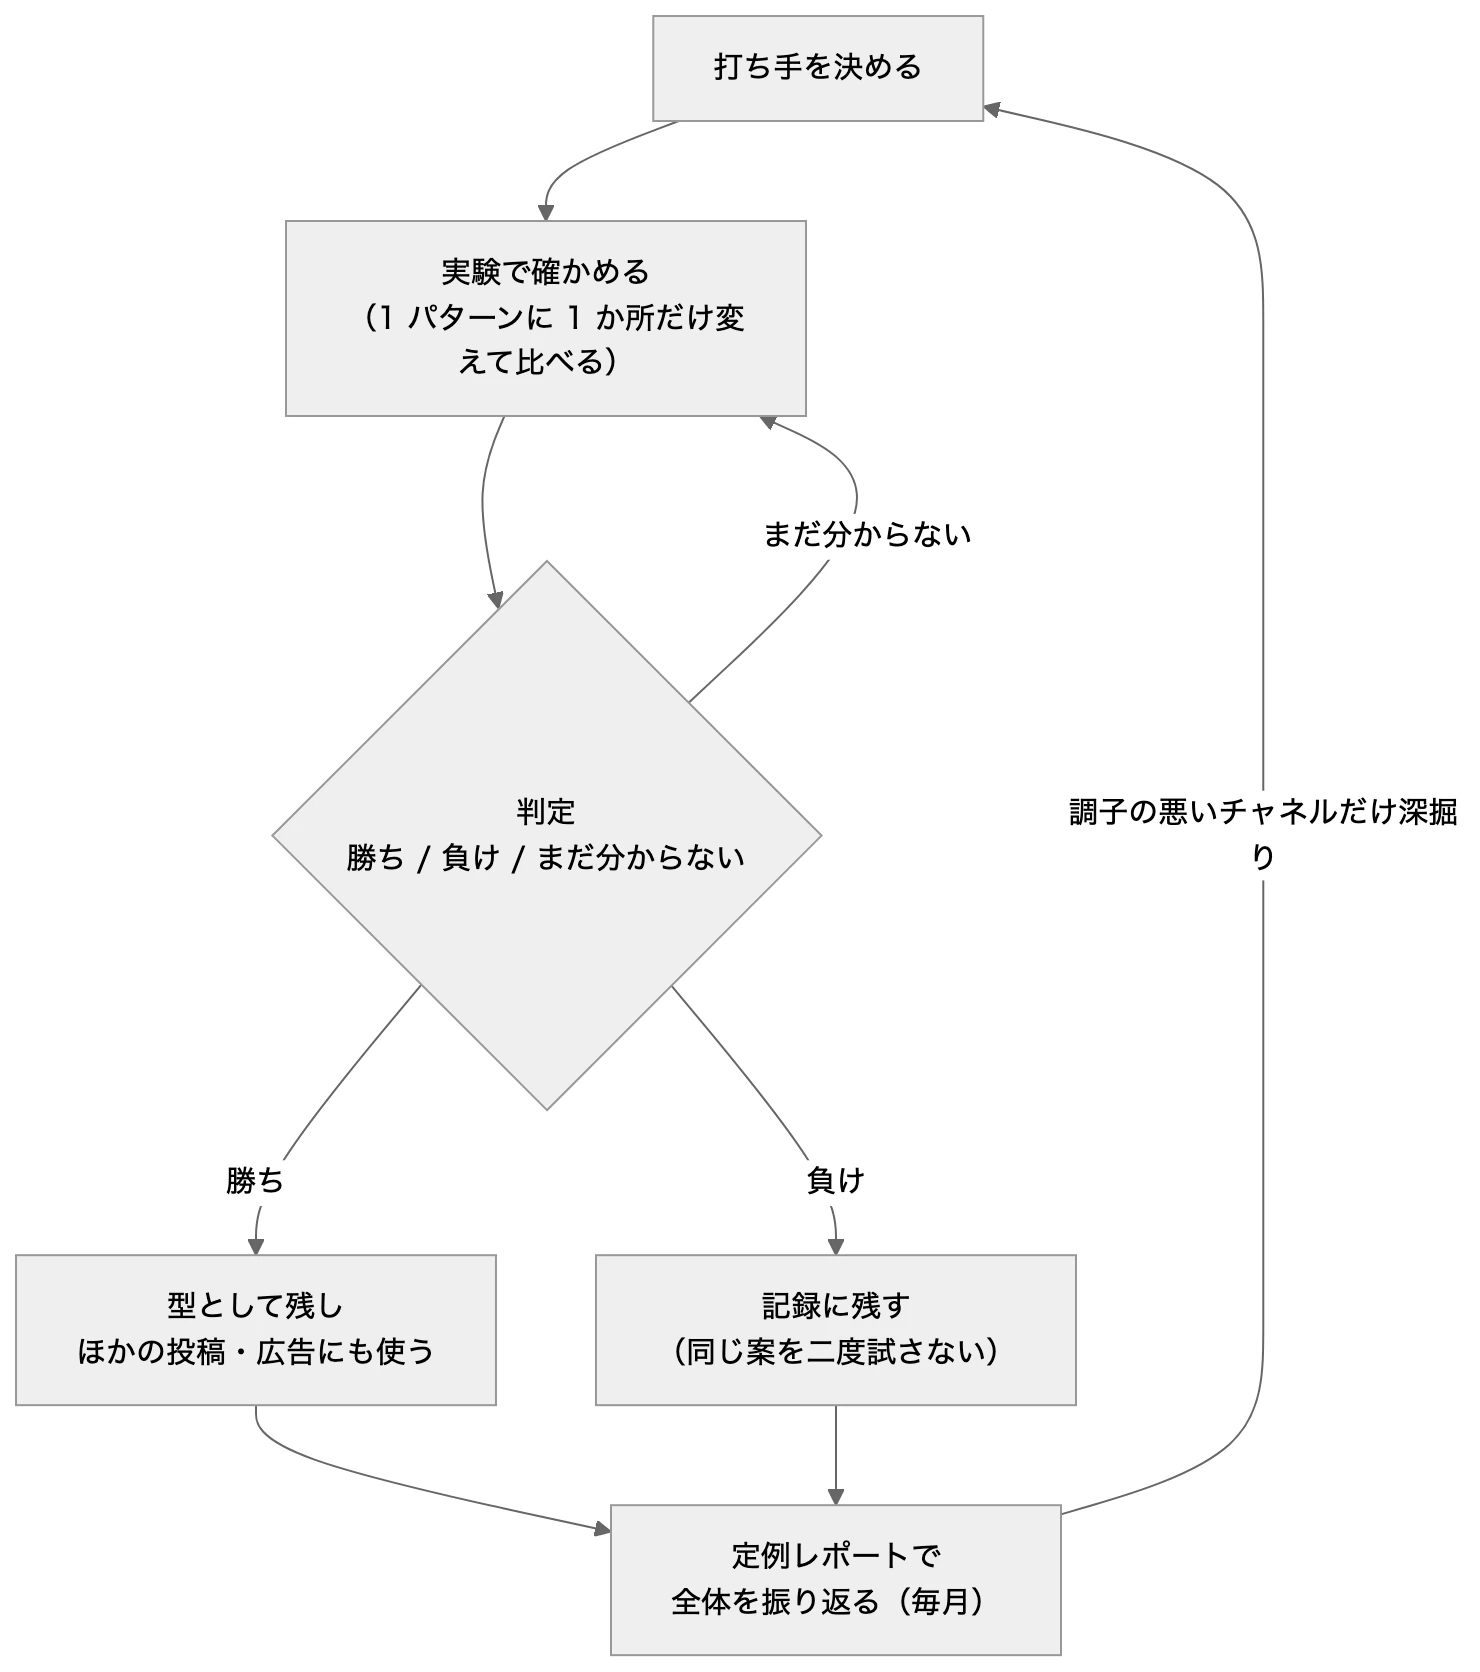
図の元になった mermaid を見る
flowchart TD
    PLAN["打ち手を決める"] --> EXP["実験で確かめる<br>(1 パターンに 1 か所だけ変えて比べる)"]
    EXP --> JUDGE{"判定<br>勝ち / 負け / まだ分からない"}
    JUDGE -->|"勝ち"| KEEP["型として残し<br>ほかの投稿・広告にも使う"]
    JUDGE -->|"負け"| LOG["記録に残す<br>(同じ案を二度試さない)"]
    JUDGE -->|"まだ分からない"| EXP
    KEEP --> REVIEW["定例レポートで<br>全体を振り返る(毎月)"]
    LOG --> REVIEW
    REVIEW -->|"調子の悪いチャネルだけ深掘り"| PLAN
実験: A/B テスト
A/B テストは、2 つの案(A と B)を同じ条件で同時に出し、どちらが良い結果になるかを実際の数字で比べる方法です。たとえば予約ページの見出しを 2 通り用意し、訪れた人を半分ずつに振り分けて、予約した人の割合を比べます。こうした比較を積み重ねて事業を伸ばす進め方は、グロースハックと呼ばれます。
A/B テストでよくある失敗が、結果を見てから「成功」の基準を決めてしまうことです。基準を後から決めると、どんな結果でも成功だと言えてしまいます。そのため、A/B テストは以下の順番で進めましょう。
- 伸ばす数字を 1 つ決める。 店舗型のビジネスなら、予約・来店・応募の件数などです。総再生数のように、増えても売上に結びつかない数字は選ばないようにしましょう。
- お客さんが離れている段階を 1 つ選ぶ。 「ページを見た → 予約を始めた → 予約を終えた」のように段階を並べ、次へ進む人の割合がいちばん低いところを選びます。
- 案に順番を付ける。 効果の大きさ・効きそうな確かさ・やりやすさで点を付け、点の高い案から試します。
- 計画シートを書く。 仮説・見る数字・悪くしてはいけない数字・成功と中止の条件を、始める前に書いておきます。
また、1 つのパターンで変えるのは 1 か所だけにしてください。見出しと写真を同時に変えた案が勝っても、どちらが効いたのかは分からないからです。見出しと写真の両方を試したいときは、見出しだけを変えた B と、写真だけを変えた C のようにパターンを分けて、元の A と同時に並べましょう。
これまで、A/B テストで試せるパターンの数は、案を作る手間で決まっていました。見出しを 10 通り、バナーを 20 枚用意するには、人が 1 つずつ作る必要があり、1 か月に試せるのは数パターンが限度だったと思います。いまは AI Agent が、案出し・素材の生成・計画シートの記入・結果の集計までを受け持てるので、同時に試せるパターンの数を大きく増やすことができます。ただし、パターンを増やすほど 1 パターンあたりの訪問者数は減り、判定までの期間が延びてしまいます。また、比べるパターンが多いほど、偶然よい数字が出ただけの案が勝ったように見えやすくなることにも注意してください。
もっと詳しく: 実際に著者が利用している実験の Skill を簡略化して添付したので参考にしてください
上で説明した 4 つのステップに、判定と記録の 2 つを足した手順になっています。「守ること」には、判定の基準を後から変えないことと、測れない数字を 0 で埋めないことを書いています。どちらも、守らないと実験の結果が信用できなくなってしまうからです。
---
name: growth-experiment
description: >-
  打ち手が効いたかを実験で確かめる。伸ばす数字を 1 つ決め、計画シートに判定の基準を始める前に書き、公開後の実際の数字で「勝ち」「負け」「まだ分からない」を判定する。「A/B テストをしたい」「この施策は効いたの」「見出しを比べたい」で使う。※全体の数字の振り返りは monthly-channel-review。
---

# 実験で打ち手を確かめる

## 手順

1. **伸ばす数字を 1 つ決める。** 予約・来店・応募の件数など。増えても売上に結びつかない数字(総再生数など)は選ばない
2. **お客さんが離れている段階を 1 つ選ぶ。** 段階ごとに次へ進む人の割合を並べ、いちばん低いところを選ぶ
3. **案を出し、順番を決める。** 効果の大きさ・効きそうな確かさ・やりやすさで点を付ける。始める前に、過去に勝った案と負けた案の一覧を読む
4. **計画シートを書き、一度止まって人の確認を取る。** 仮説・見る数字・悪くしてはいけない数字・成功と中止の条件・判定する日を書く。1 パターンで変えるのは 1 か所だけ
5. **公開後の実際の数字で判定する。** 案ごとの件数が計画シートで決めた数に届くまでは「まだ分からない」と返す。判定は計算で行い、会話の中で決めない
6. **結果を記録に残す。** 勝った案は型として一覧に入れる。負けた案も消さない

## 守ること

- 判定の基準は、始めたあとに変えない
- 測れない数字では実験を組まない。測れていない数字は「未取得」と書き、0 で埋めない
- 記録は作業のたびに消えない場所(共有ドライブや記録シート)に置く。前回の記録が見つからないときは「初回」と読み替えず、「見つからなかった」と書く
- 報告は「勝ち」「負け」「まだ分からない」の 3 つで書き、数字には意味の文を添える(例: 「予約ページを見た 100 人のうち、予約を始めた人が 4 人から 5 人に増えた」)
定例レポート: チャネルを足さずに並べる
実験が個々の打ち手を確かめるものなのに対して、定例レポートは「全体としてうまくいっているか」を確かめるものです。定例レポートで最も起きやすい間違いが、全チャネルの数字を合計してしまうことです。MMM の節でも説明したように、予約の数え方は広告媒体ごとに違います。また、TikTok の再生数と Instagram の表示回数も、数えているものが違います。見た人の人数のように重複を除いた数字は、足してしまうと同じ人を二度数えることになります。広告費だけは合計しても問題ありませんが、合計した広告費を合計した予約数で割った「1 件あたりの費用」は誤った値になることがあります。そのため、全体の調子は合計ではなく、チャネルごとの判定を並べた表で示すようにしましょう。
もっと詳しく: 実際に著者が利用している定例レポートの Skill を簡略化して添付したので参考にしてください
定例レポートを作る手順を、数字を集める順番に並べています。「守ること」の先頭に「チャネルの数字を合計しない」を置いているのは、AI は頼まれていなくても合計の行を作ってしまいがちだからです。
---
name: monthly-channel-review
description: >-
  チャネル横断の定例レポート。検索・サイト・広告・SNS・Google マップの数字をチャネルごとに同じ期間で並べ、目標比・前回比・判定・次の一手まで 1 本にまとめる。「今月の数字をまとめて」「定例レポート」「全体の調子どう?」で使う。※チャネル単体の深掘りは各チャネルの分析のスキル、実験の判定は growth-experiment。
---

# 定例レポート

## 手順

1. **つながっているチャネルを確かめる。** 実際に数字が取れたものだけを載せる。取れないチャネルは「未取得」と書き、つなぐ方法を添える
2. **目標と前回の数字を集める。** 目標は案件の設定から引く。無ければ前回比だけで組み、冒頭に「目標が未設定」と書く。前回のレポートが見つからないときは、探したうえで「今回が基準」と書く
3. **チャネルごとに同じ期間の数字を並べ、判定する。** ◎○△✕ の 4 段階と、理由を 1 行
4. **気になることを先頭に書く。** 「期間 + 実際の数字 + 変化量」で名指しする
5. **次にやることを 3 つまで書く。** 判定が △ か ✕ のチャネルだけを、それぞれの分析の手順へ回す
6. **末尾に次回のための数値表を残す。** チャネル・指標・値・期間の表

## 守ること

- チャネルの数字を合計しない。広告費だけは合計してよいが、合計から 1 件あたりの費用は出さない
- 予約が 0 件のときは、1 件あたりの費用を「—」と書く(0 円と書くと、安く獲れているように見える)
- 実験の勝ち負けは、実験の Skill の結果をそのまま引用し、判定し直さない
- 読み手は広告に詳しくない人。「一言でいうと」から始め、略語を使わない
この Skill で作ったレポートは、例えば以下のようになります(数字は架空です)。
| チャネル | 主な数字 | 目標比 | 前回比 | 判定 | 理由 |
|---|---|---|---|---|---|
| Meta 広告 | 予約 21 件(Meta の数え方)、1 件あたり 7,100 円 | 目標の 8,000 円より安い | −6% | ○ | 素材の入れ替えで費用が少し下がった |
| 自然検索 | クリック 1,240 回 | 未設定 | +18% | ◎ | 「日帰り 貸切風呂」の検索で表示が増えた |
| 未取得 | — | — | — | 連携が切れている。連携し直せば次回から載る |
情報収集を自動化する
チャネルルーティングを作る
情報の集め方を AI に任せきりにすると、作業のたびに使う道具が変わってしまいます。前回は API から、今回は公開ページから取った数字だと、値が変わっても事業が動いたのか取り方が変わったのかが分かりません。そこで、「何を調べるときに何を最初に使い、使えなければ何に切り替えるか(縮退先)」を表にして Skill にしておきます。本書ではこれを「チャネルルーティング表」と呼びます。
参考までに、著者が実際に使っているチャネルルーティング表を載せておきます。道具の名前は自分の環境に合わせて置き換えてください。
## チャネルルーティング表

| 目的 | 第一手 | バックアップ |
|---|---|---|
| テキスト情報の検索(事例・ニュース・人物) | Web 検索ツール | 言い換え/サジェスト → site: 検索 → 英語圏展開 |
| 特定ページの取得(静的) | ページ取得ツール(WebFetch 等) | UA 指定で取得できるページ取得 → JS レンダリングして読む取得(ヘッドレスブラウザで描画。403 時) |
| 動的一覧・ページネーションのクロール | JS レンダリングして読む取得(リンクが HTML に出ていれば全件取れる) | ブラウザ実査(Playwright MCP 等。**アクセス先は案件のサイト・登録した競合・主要な公開プラットフォームに限る**。Meta・TikTok・X は対象外) |
| SNS の実数・実在確認(フォロワー・再生数) | **Instagram / TikTok は人が画面で確認した値か公式 API の値だけ**(自社アカウントのインサイト、Instagram の Business Discovery API)。X は公式 API | ユーザーに画面の確認・スクショ提供を依頼する。取れなければ「未取得」。**ログインが要る数字は取れない** |
| 要ログイン SaaS の取得 | **取らない**(ログインを代行しない・認証を回避しない) | 管理画面のエクスポート(CSV)/スクショの持ち込みを依頼する |
| 動画広告・当たりクリエイティブ | 広告ライブラリを人が開いて記録する(手順は `ad-library-research`)か、広告データを API / MCP で提供する商用サービス(推定値は推定と明記) | Google 広告の透明性センター・TikTok Creative Center(どちらも人が開いて記録) |
| 定点巡回(RSS/フィード) | ページ取得ツール、またはフィードの読み取り(Python の feedparser 等) | UA 指定で取得できるページ取得(403 時) |
| 検索順位・アクセス・広告の実績(Search Console / GA4 / 各媒体) | Search Console・GA4・広告媒体の API / MCP(連携していれば)。**これが唯一の経路** | 取れなければ「連携が未設定」と報告する。**Web 側で代替しない**(公開ページの数字は別のものになる) |
| YouTube の公開データ | YouTube Data API(鍵があれば) | ページ取得(動画ページ)→ ブラウザ実査 |
| 社内情報(ドキュメント・ドライブ) | ドキュメント基盤・ドライブのコネクタ / MCP(**読み取りのみ**) | ユーザーにファイルの持ち込み(チャット添付)を依頼する。Web 側で代替しない |
定点監視を作る
情報収集の自動化の中でも、最も効果が大きいのが定点監視です。定点監視とは、決めた対象を、決めた間隔で、同じ方法で集めて、前回との差分だけを知らせる仕組みです。競合の動きや業界ニュース、自社への言及などを、人が毎朝ブラウザで確認して回る方式(pull 型)から、差分だけが通知される方式(push 型)に変えることができます。この節では、対象によらず共通する仕組みを説明します。前述した競合調査や、後述するブランドリスニング(ソーシャルリスニング)の自動化にも応用することができます。
push 型にする目的は、結果を読む人の負担を減らすことです。pull 型では、人が対象を 1 つずつ開いて、前回の状態を思い出し、どこが変わったかを自分で比べる必要があります。変化が無い日も同じ手間がかかりますし、対象が増えるほど確認の抜けや見落としも増えていきます。push 型なら、前回との比較は仕組みが行うので、人が受け取るのは変わったところだけです。人は、届いた差分に対応するかどうかを判断することに集中できるようになります。
これは、結果を読むのが人ではなく AI Agent の場合も同じです。例えば、複数のサブエージェントを束ねて次の手を決めるメインのエージェントに、各チャネルで集めたデータをそのまま渡すと、メインのエージェントのコンテキストの大半が変化の無いデータで埋まってしまい、判断に使える分が減ってしまいます。差分と重要度の判定だけを渡すようにすれば、少ない入力で次の手を選ぶことができます。
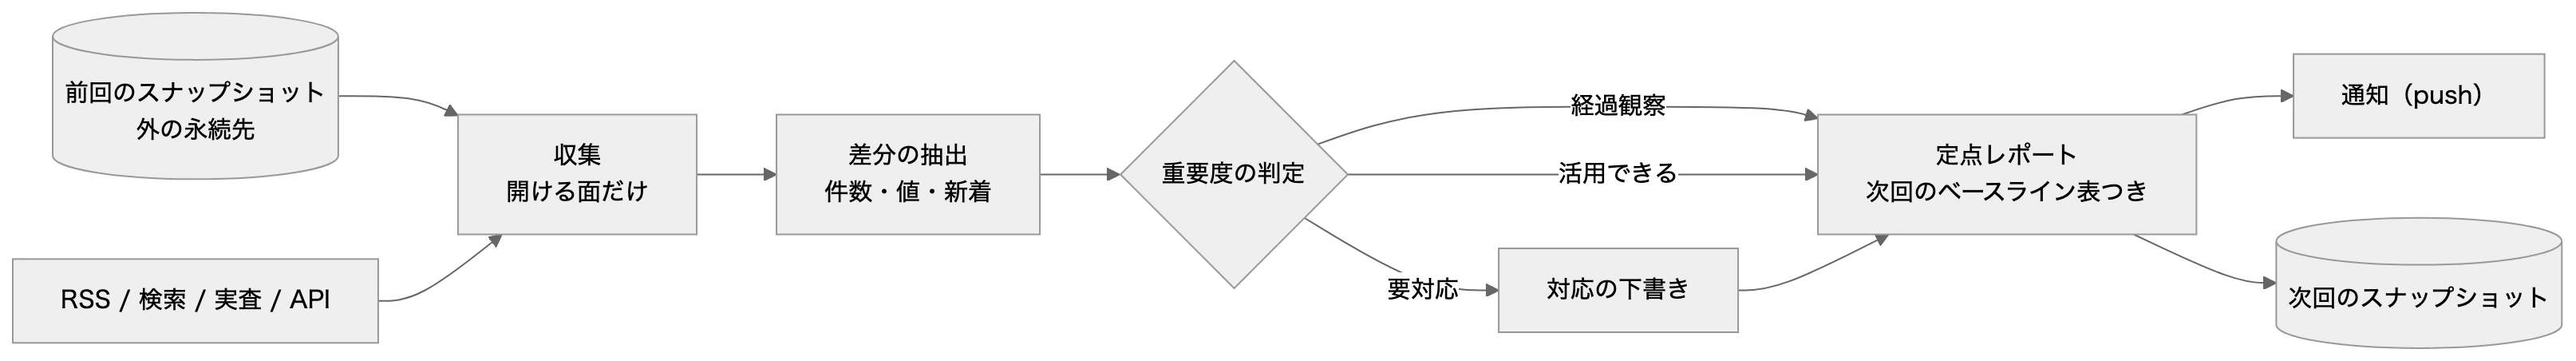
図は横にスクロールできます。図を原寸で開く
図の元になった mermaid を見る
flowchart LR
    PREV[("前回のスナップショット<br>外の永続先")] --> COLLECT["収集<br>開ける面だけ"]
    SRC["RSS / 検索 / 実査 / API"] --> COLLECT
    COLLECT --> DIFF["差分の抽出<br>件数・値・新着"]
    DIFF --> TRIAGE{"重要度の判定"}
    TRIAGE -->|"要対応"| DRAFT["対応の下書き"]
    TRIAGE -->|"経過観察"| REPORT
    TRIAGE -->|"活用できる"| REPORT["定点レポート<br>次回のベースライン表つき"]
    DRAFT --> REPORT
    REPORT --> NOTIFY["通知(push)"]
    REPORT --> NEXT[("次回のスナップショット")]
ブランドリスニング(ソーシャルリスニング)を作る
ソーシャルリスニングは、SNS や口コミサイトに投稿された消費者の声を集めて分析するマーケティングの手法です。自社やブランドの評判、キャンペーンへの反応、不満の傾向などを知るために使います。
本書では、自社のブランドや店舗への言及・口コミを対象にしたソーシャルリスニングを「ブランドリスニング」と呼びます。仕組みは前の節で説明した定点監視と同じですが、ブランドリスニングでは次の 3 つを決めておく必要があります。
- 表記ゆれを最初に洗い出す。 ひらがな・カタカナ・英字・略称・旧店名などを並べてから検索させます。正式名だけで検索すると、不満を書く人の投稿をまるごと取りこぼしてしまいます。否定的な言及ほど、正式名では書かれないことが多いからです。
- 要対応の基準を決めておく。 著者は、事実誤認・衛生や安全・返金やクレーム・複数のチャネルに同じ話題が出ている、の 4 つを要対応とし、それ以外は経過観察か活用に分けています。
- 頻度を決めておく。 基本は毎週で、キャンペーン中や炎上への対応中は毎日にします。
口コミは毎週見るものなので、これらの決めごとを毎回プロンプトで指示していると、媒体選定のときと同じように、書き忘れた回だけ数え方が変わって前回と比べられなくなってしまいます。そのため、著者は手順を Skill にまとめて、AI Agent に組み込んでいます。
もっと詳しく: 実際に著者が利用しているブランドリスニングの Skill を簡略化して添付したので参考にしてください
上で説明した 3 つの決めごとに、前回の数字を読み込むことと、チャネルごとに数えることを足した手順になっています。「守ること」には、開けなかったチャネルを 0 件と書かないことを入れています。「言及が無かった」ことと「見られなかった」ことは、まったく別の事実だからです。
---
name: brand-listening
description: >-
  ブランド・店舗の口コミや言及を、Googleマップ・予約/グルメサイト・X・Instagram・TikTok・Web 記事から定点で集め、前回との差と要対応をまとめる。「口コミを監視して」「評判を調べて」「炎上してないか見て」「毎週評判をチェックして」で使う。※競合の評判は競合の定点監視の Skill。
---

# ブランドリスニング(口コミ・言及の定点監視)

## 手順

1. **前回の数字を読み込む。** 前回のレポートか記録シートから取る。見つからなければ「今回が初回。前回との差は次回から出せる」と書く
2. **表記ゆれを並べてから検索する。** ひらがな・カタカナ・英字・略称・旧店名。X は Yahoo!リアルタイム検索、Web は「[店名] 口コミ」「[店名] ひどい」まで含めて検索する。Instagram・TikTok は公式 API か、人が画面で見て記録した分だけを使う
3. **チャネルごとに件数・評点・新着を数える。** 数えるのはコードで行い、生成 AI には本文の要約とトーンの判定だけを任せる
4. **要対応を分ける。** 事実誤認・衛生や安全・返金やクレーム・複数チャネルに同じ話題、の 4 つを要対応にし、それ以外は経過観察か、好意的な投稿の活用に分ける
5. **レポートにまとめる。** 「一言でいうと」から始め、要対応を先頭に置く。チャネル別の数字の表(件数・評点・前回比・取得日)を残し、次回の比較に使う

## 守ること

- X・Instagram・TikTok の画面を自動で集めない(各社の規約が禁じている)。ログインが要る面は取らない
- 開けなかったチャネルは「未取得」と書き、0 件と書かない
- チャネルをまたいで件数を合算しない(数えているものが違う)
- 「急増」は「直近 7 日で 18 件、前週は 3 件」のように期間と実数で書く
- 通知先を決めてから定期実行に載せる
トレンド便乗の検知と判定
世の中でいま話題になっているニュースや流行を自社の発信に取り入れ、注目を集める手法を「ニュースジャック」や「トレンドジャック」と呼びます。話題に乗ることで、ふだんは届かない人にも投稿が届きやすくなります。一方で、SNS は拡散が速いぶん、便乗の仕方を誤ると短時間で批判が広がり(炎上)、ブランドの信頼を損ないます。そのため、「乗れるか」より先に「乗ってよいか」を判断する手順が必要です。
いま話題になっていることは、API もログインも不要で、X の話題なら Yahoo!リアルタイム検索、検索の急上昇なら Google トレンドなどから取得することができます。TikTok の流行は TikTok Creative Center で確認できますが、規約上、自動では集められないので、人が開いて見た話題を記録するようにしましょう。見つけた話題は、便乗してよいかを判定してから投稿の案にします。
もっと詳しく: 実際に著者が利用しているトレンド便乗の Skill を簡略化して添付したので参考にしてください
便乗してよいかの判定を手順の 2 番目に置いているのは、判定を飛ばしていきなり投稿案を作ってしまうことを防ぐためです。また、見送った話題も理由と一緒に残させているのは、次に似た話題が来たときに素早く判断できるようにするためです。
---
name: trend-watch
description: >-
  いま話題のトレンドを見つけ、ブランドが便乗してよいかを判定してから、投稿案にする。「トレンドに乗りたい」「いま話題の◯◯で投稿案を」「今日のトレンドを見て」で使う。投稿はしない(投稿は第 7 章の投稿の Skill)。
---

# トレンド便乗(見つける → 判定する → 投稿案)

## 手順

1. **公開の面から話題を拾う。** Yahoo!リアルタイム検索・Google トレンド・期間を 24〜72 時間に絞った Web 検索を見る。TikTok Creative Center は人が開いて記録した分だけを使う。話題ごとに URL と見た時刻を付ける
2. **便乗してよいかを判定する。** 災害・事故・訃報・事件、係争中の話題、個人への攻撃、宗教・政治の対立には乗らない。他社の炎上、権利のある音源や映像、真偽が固まっていない速報は慎重に扱う。迷ったら乗らない
3. **ブランドとのつながりを 1 行で書く。** 「[話題] × [自社の持ちネタ]」の形で言えない話題は案にしない
4. **投稿案を書く。** 文面か動画の企画に、いつまでに出す価値があるか(48 時間以内 / 週内 / 季節もの)を添える
5. **見送った話題も理由と一緒に残す。** 乗る話題が無い日は「今日は乗る話題なし」と書き、季節の定番ネタの案だけを返す

## 守ること

- 投稿はしない。案を人に渡すところで止める
- TikTok・Instagram・X の画面を自動で集めない(各社の規約が禁じている)
- 根拠の無い「話題になっているらしい」を案の前提にしない。取れなかった数字は「未取得」と書き、推定で埋めない
各媒体の API
定点監視やトレンドの検知を自動で回すために、各媒体が公式に提供している API を使うこともできます。主な API の状況は以下のとおりです(執筆時点の情報なので、実装する前に必ず最新の情報を確認してください)。
| 取得元 | 状態 | 取れるもの・条件 |
|---|---|---|
| Google トレンドの公開データ(BigQuery) | 取れる(審査不要) | 国別の上位検索語と急上昇語。任意のキーワードの時系列は取れず、ランキングだけ |
| YouTube Data API の急上昇 | 取れる(鍵が要る) | 地域ごとの人気動画一覧 |
| TikTok のトレンド(Discovery API) | 申請が要る | 業種別の人気ハッシュタグ・商用利用可の楽曲・トレンド検索語 |
| Instagram のハッシュタグ検索・他アカウントの公開指標 | 申請が要る | 投稿側の連携とは別の経路と審査。タグ数に上限 |
| Meta の広告ライブラリ(API) | 日本の商用広告は取れない | EU 以外は社会問題・選挙・政治の広告のみ。人が画面で検索するか商用サービス |
| X のトレンド(API) | 取れるが高い | 従量課金で定期取得すると費用が現実的でない。公開面を人が確認する |
| Pinterest のトレンド API | 取れない | 執筆時点で日本のリージョンが無い |
RSS について
定点監視の材料として、最も安く安定して使えるのが RSS です。RSS とは、Web サイトの更新情報を機械が読める形で配信する仕組みのことで、主に以下のようなものを取得することができます。
| 取れるもの | 用途 | 備考 |
|---|---|---|
| ニュースサイト・企業のお知らせ・ブログ・note・Podcast | 業界ニュース、競合の PR、業界人の発信 | フィードの URL はサイトごとに違う。多くはページの head に自動検出用のリンクがある |
| YouTube のチャンネル | 競合チャンネルの新着動画 | チャンネル単位のフィードがある |
| Google トレンド(急上昇ワード) | 検索需要の立ち上がり | https://trends.google.com/trending/rss?geo=JP(執筆時点) |
| Google アラート・GitHub のリリース | ブランド名の言及、使っているツールの更新 | アラートは配信先に RSS を選べる(既定はメール) |
章のまとめ
- 戦略設計も、第一章で説明した「整理 → 連携 → 自動化」の順で進めます。整理にあたる事業の定義は、ブランドナレッジ(何者か)とカスタム指示(どう動いてほしいか)に分けて用意し、最初に聞いた答えは案件ごとに保存しておきましょう。
- 3C・N1・ペルソナといった分析のフレームワークは AI に任せることができます。ただし、「訴求と媒体が決まるまで具体化する」「質問する前に調べる」「仮定は仮定と書く」「読み手は広告も SaaS も分からない人」の 4 つは、Skill に書いて固定しておきます。
- 業界の数字は出典の付いた信頼できる情報源から引き、「使ってはいけない数値」の欄と信頼度のラベルを用意しておきます。また、資料の末尾には「データの限界」を書いておきましょう。
- 競合調査は、単発の深掘り・定点の差分・広告の実査の 3 つに分けて考えます。広告ライブラリには出稿額や再生数が載っていないので、当たっている広告は継続配信日数で判定します。Meta・TikTok は規約で自動収集が禁止されているので、人が記録するか商用サービスを使いましょう。
- 広告・検索(AI 検索を含む)・アカウント運用の 3 つの打ち手は、互いの代わりにはなりません。関心度の 3 層で入口を選び、媒体は同じ条件で比べ、成果は媒体をまたいで合算しないようにします。そして何より先に、LP と計測の仕組みを用意しておきましょう。
- 複数の媒体の予算配分は、自社の売上を目的変数にした MMM で応答曲線を推定して決めます。MMM の Skill では、毎回同じ結果が出るスクリプトを「検査 → 推定 → 診断 → 報告」の順に動かし、途中の 4 箇所で一度止まるようにしています。診断に落ちた配分は出さず、媒体の予算も AI には変更させません。
- 実験は判定の基準を始める前に決めておき、勝ち負けは実際の数字と統計的な検定で判断します。定例レポートではチャネルの数字を合計せず、取得できなかった行も消さずに残し、次回のための数値表を付けておきましょう。
- 情報収集の道具は「読むだけ」のものと「操作できる」ものに分け、操作できる道具だけを許可リストで制限します。定点監視では前回の値を外部に保存しておき、件数を数える処理には生成 AI を使いません。また、AI に任せるのは下書きまでにして、通知先を決めてから定期実行に載せるようにしましょう。
- RSS は最も安く使える定点監視の材料です。X の API は料金と規約を公式の情報で確認し、取れないものは「未取得」と書くようにします。
演習
- 自分が担当している事業について、「何者か」と「どう動いてほしいか」を分けて書き出し、それぞれの項目を誰が更新するかも書いてみましょう。
- 競合を 1 社選び、Meta の広告ライブラリで配信中の広告を継続配信日数の順に並べてみましょう。出稿額や再生数は使わずに、「何が効いていると推定できるか」を 3 行で書いてください。
- 手元の売上と広告費を週ごとの CSV にまとめ、mmm-quickstart の
checkを通してみましょう。STOP か WARN が出た項目について、データの側で何を直せばいいかを書いてください。 - 業界ニュースの RSS を 3 本選び、既読の記録を外部に保存しながら定期的に取得する処理を書いてみましょう。新着の記事だけを LLM に渡して、「自社に関係あるか」を判定させてください。
- 自分が担当している打ち手を 1 つ選び、実験の計画シートを埋めてみましょう。成功と中止の条件は数字で書き、計測する手段が無い指標は使わないようにしてください。
- 先月の数字で、チャネル別の成績表を作ってみましょう。合計の行は作らず、取得できなかったチャネルには「未取得」と、連携する方法を書いてください。
次の章へ
この章では、戦略設計に必要な事業の定義と、情報収集の仕組みを整えました。次の第四章「クリエイティブ作成を自動化する」では、これらを材料にして、コピー・バナー・動画・LP を AI で生成する方法と、生成したものの来歴を保存する設計について解説します。