
第6章 SEO/LLMO を自動化する
SEO の仕事を 5 つの領域に分けた監査の自動化、Search Console と GA4 の連携の作法、順位計測と記事生成での承認の置き方、AIO・GEO・LLMO の違いと、AI の回答での言及を定点で測る設計を解説します。
執筆中この章は執筆中です。書きかけの節があり、内容はこれから変わることがあります。
この章で学ぶこと
- SEO の仕事を 5 つの領域に分け、監査を「1 つの入口から委譲する」形で自動化する
- Search Console と GA4 の連携の作法(クライアントは 1 つ、単位は経路ごと、鍵があることと読めることは別)
- 順位計測・無料 API・記事生成・インデックス送信で、どこに人の承認を残すか
- E-E-A-T と検索意図でコンテンツの質を点検し、生成 AI を使わない「機械的な提案」を出す
- AIO・GEO・LLMO の違いと対策、クエリファンアウトとコサイン類似度、AI の回答での言及を定点で測る設計
広告はクリックから成果までの距離が短く、数字が翌日には返ってきます。SEO は逆です。書いてから効き始めるまでに数週間かかり、AI 検索の回答面ではさらに間接的にしか効きません。時間がかかる仕事だからこそ、計測の土台を先に作り、自動化する部分と人が判断する部分を最初に分けておきます。第 1 章で述べた 3 つの順番(整理 → 連携 → 自動化)は、ここでも飛ばせません。店舗の Google ビジネスプロフィールを整えるローカル SEO(MEO)は第 8 章に譲ります。
SEO の仕事を分解する
5 つの領域と、それぞれの正本
「SEO をやる」と一語で言ってしまうと、自動化の取っかかりがありません。領域ごとに、見るもの・数字の出どころ・失敗のしかたがまるで違うからです。まず表にして分けます。
| 領域 | 何を見るか | 数字の出どころ | よくある失敗 |
|---|---|---|---|
| テクニカル | クロール・インデックス・表示速度・構造化データ・JS 描画 | サイトそのものと実利用者の速度データ | JS でしか描画されないタグを「入っている」と数える |
| コンテンツ | 検索意図の網羅・一次情報・E-E-A-T・既存記事の改善 | 上位ページの実測と自社の一次情報 | 上位の要約を寄せ集めた「平均のページ」を量産する |
| 被リンク | 参照ドメイン・アンカーテキスト・有害リンク | 無料 API で取れる範囲だけ | 取れない指標を推測値で埋める |
| ローカル | ビジネスプロフィール・口コミ・NAP の一貫性 | 地図側(第 8 章) | 地図を先に整えるべき案件で、サイトから直す |
| 計測 | クリック・表示回数・CTR・順位・セッション・CV | Search Console / GA4 / 順位スナップショット | 単位と定義を確定せずに足す |
E-E-A-T は Google の品質評価の観点(経験・専門性・権威性・信頼性)、NAP は店名・住所・電話番号、CV(コンバージョン)は予約や問い合わせなど成果の件数を指します。
領域の横に、段階のオントロジーを一本通す
領域で分けると「誰が何を見るか」は決まりますが、「いま何をすべきか」は決まりません。上の 5 つは並列で、順序を持っていないからです。実際、「SEO を改善して」と頼むと、テクニカルの指摘が 40 件並んだレポートが返ってくることがあります。その案件の問題が「そもそも誰に向けた言葉で書いているのか決まっていない」ことだったとしてもです。
順序を持たせるのが、段階のオントロジーです。第 2 章ではモノと関係の図を描きましたが、SEO で同じ役割を果たすのは「仕事がどの段にあるか」を名前で持つことでした。著者が使っているのは FLOW(Find → Leverage → Optimize → Win)という公開のフレームワークです(Daniel Agrici 氏による CC BY 4.0 の公開物。github.com/AgriciDaniel/flow)。
| 段 | この段で決めること | ここで詰まっている印 |
|---|---|---|
| Find(見つける) | 需要の言葉。誰が、どんな言葉で探しているか | 狙う言葉が人によって違う。上位に何が並んでいるかを説明できない |
| Leverage(活かす) | 外側に散らばっている裏づけ。被リンク・掲載・口コミ・言及 | 自社サイトの外に、自分たちを裏づけるものがほとんど無い |
| Optimize(整える) | 自社の資産を、読み取りやすく信じられる形にする | 中身はあるのに、抜き出して引用できる形になっていない |
| Win(結びつける) | 見つけてもらうことと、事業の成果をつなぐ | 流入は伸びているのに、予約や問い合わせが増えていない |
使い方は 1 つだけです。どの段で詰まっているかを先に判定し、その段の仕事だけをやる。 需要の言葉が曖昧なら Find へ戻ります。外側での裏づけが無ければ Leverage。資産が読み取りにくければ Optimize。流入があるのに事業への影響が弱ければ Win へ進みます。
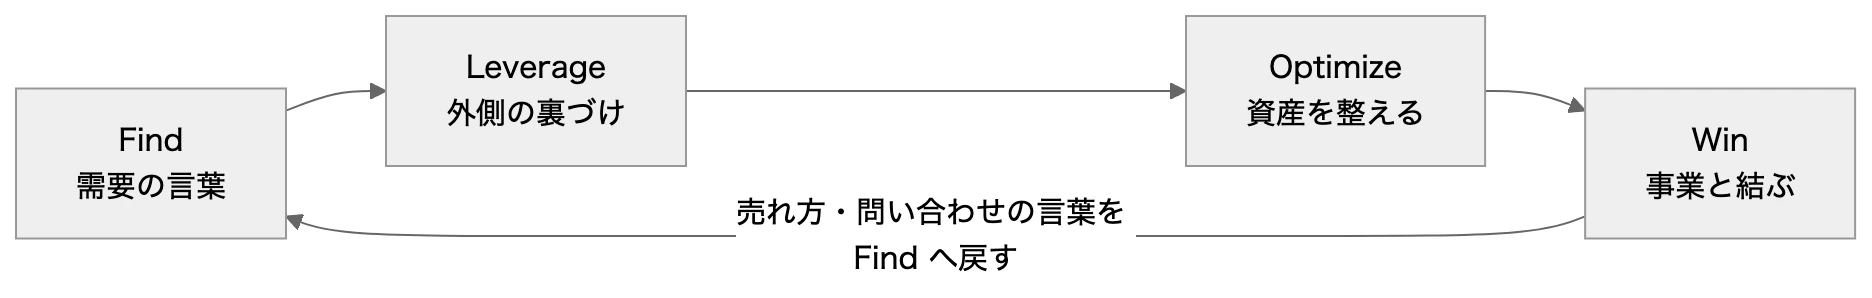
図の元になった mermaid を見る
flowchart LR
  F["Find<br>需要の言葉"] --> L["Leverage<br>外側の裏づけ"]
  L --> O["Optimize<br>資産を整える"]
  O --> W["Win<br>事業と結ぶ"]
W -->|"売れ方・問い合わせの言葉を Find へ戻す"| F領域と段は直交します。段が「いまどこをやるか」を決め、領域が「それを誰に渡すか」を決めます。同じテクニカルの仕事でも、Optimize の段なら「抜き出しやすさ」が目的で、Win の段なら「問い合わせまでの導線」が目的になる。目的が違えば、同じページを見ても出てくる指摘が変わります。
このフレームワークが本書の方針と重なるのは、エビデンス(裏づけ)を先に棚卸しするところです。書き始める前に、顧客の言葉・検索の実績・プロフィールの中身・口コミ・アクセスの数字・商談で出た反論といった、既に手元にある材料を並べる。強いページは白紙からの発想ではなく、出典の揃った表から生まれます。規則も 2 つだけです。
- どの検索面に向けて書くのかを、書き始める前に明示する(通常の検索結果・AI の回答・地図の枠・コミュニティの議論・広告の遷移先・営業が使う資料のどれか)。面を決めないまま書くと、どこでも中途半端なページになります。
- 観察できた事実と仮説を分ける。出典に辿れない数値は、直すのではなく削る。 本書で繰り返している「取れなかった数字をゼロで埋めない」と同じ規則を、執筆の側に当てたものです。
測り方も段と対にします。可視性の指標(順位・表示回数・地図の枠への掲載・AI の回答での引用)だけを並べず、質の高い問い合わせ・電話・フォームの送信・商談と並べて読みます。測れないページは、評価する前に計測を足します(先に評価しても、良し悪しの根拠がどこにも無い)。そして出来上がったものは、3 種類の読み手で見直します。買い手、検索エンジン、そして後でその事業を要約・比較しうる AI のことです。最後の読み手については、この章の終盤で改めて扱います。
著者の環境では、この 4 段をスキルの 1 つとして持ち、段ごとに「この段で聞くこと」の問いを並べてあります。負けているのは、段の判定を飛ばして Optimize の問いを全部流してしまうときです。指摘は増えますが、手を動かす人はどれからやればよいか分からない。だから手順書の先頭に、段を 1 つに絞るところを置いています。段が決まって初めて、下の監査の入口に渡せます。
この段の判定を手順書にすると、次のようになります。この章で本文の途中に添える手順書はどれも本文の規則を畳んだ骨子で、description には依頼の言い方と扱わない依頼の行き先を書いています(第 2 章)。
---
name: flow-stage-check
description: >-
  SEO の仕事が 4 段(需要を見つける / 外側の裏づけ / 資産を整える / 事業と結ぶ)の
  どこで詰まっているかを判定し、その段の仕事だけを出す。
  「SEO のどこから手をつければいい」「やることが多すぎて決められない」で使う。
  ※段が決まってから、監査の入口や各担当のスキルへ渡す。
---
# どの段で詰まっているか

## 手順
1. 4 つの問いに順に答える。最初に「いいえ」になった段で止める
   - 誰がどんな言葉で探しているかを、実数と上位の顔ぶれで言えるか
   - 自社サイトの外に、自分たちを裏づけるものがあるか
   - 自社のページは、抜き出して引用できる形になっているか
   - 流入が、予約や問い合わせにつながっているか
2. 止まった段を宣言し、**その段の施策だけ**を並べる
3. 他の段の施策は「今回はやらない」と書いて残す

## 守ること
- 書き始める前に、どの検索面に向けるのかを明示する
- 出典に辿れない数値は、直すのではなく削る
- 可視性の指標だけを並べない(問い合わせや予約と対で読む)
この手順書は、段を判定して宣言するだけで、判定した段の仕事は自分ではしません。判定と作業を 1 つの手順書に入れると、判定を飛ばして作業に入るのを止められないからです。「SEO を改善して」の一言でテクニカルの指摘が 40 件並ぶのは、段の判定を飛ばして Optimize の問いを全部流したときだと述べました。手順の 1 が、最初に「いいえ」になった段で止まる形をしているのはそのためです。この段階の依頼には、領域の名前がまず出てきません。そこで description の依頼の言い方は「どこから手をつければいい」「決められない」にしました。「監査して」の語で立つ手順書に渡ると、判定の前に監査が始まります。
手順の 3 で他の段の施策を「今回はやらない」と書き残させるのは、段が動くからです。Win まで進めば Find へ戻るので、今回やらない施策は捨てずに次の回の候補として残します。守ることの 3 つは、どの段でも変わらない執筆と計測の規則なので、依頼文ではなく手順書に置きました。面を決めないまま書くとどこでも中途半端なページになり、出典に辿れない数値は「取れなかった数字をゼロで埋めない」を執筆の側に当てて削ります。可視性の指標だけを並べさせないのは、流入は伸びているのに予約が増えていない Win の詰まりが、順位の表だけでは見えないからです。
監査は 1 つの入口から委譲する
サイト全体の監査は、1 つのオーケストレータが専門の担当へ仕事を振る形にします。オーケストレータが自分でやるのは 3 つだけ。トップページを描画して業種(SaaS・店舗・EC・メディア・代理店)を見立て、robots.txt を尊重しながら数百ページまでクロールし、見立てに応じてどの担当を呼ぶかを決める。所見は最後に 1 つのヘルススコアとアクションプランへまとめます。
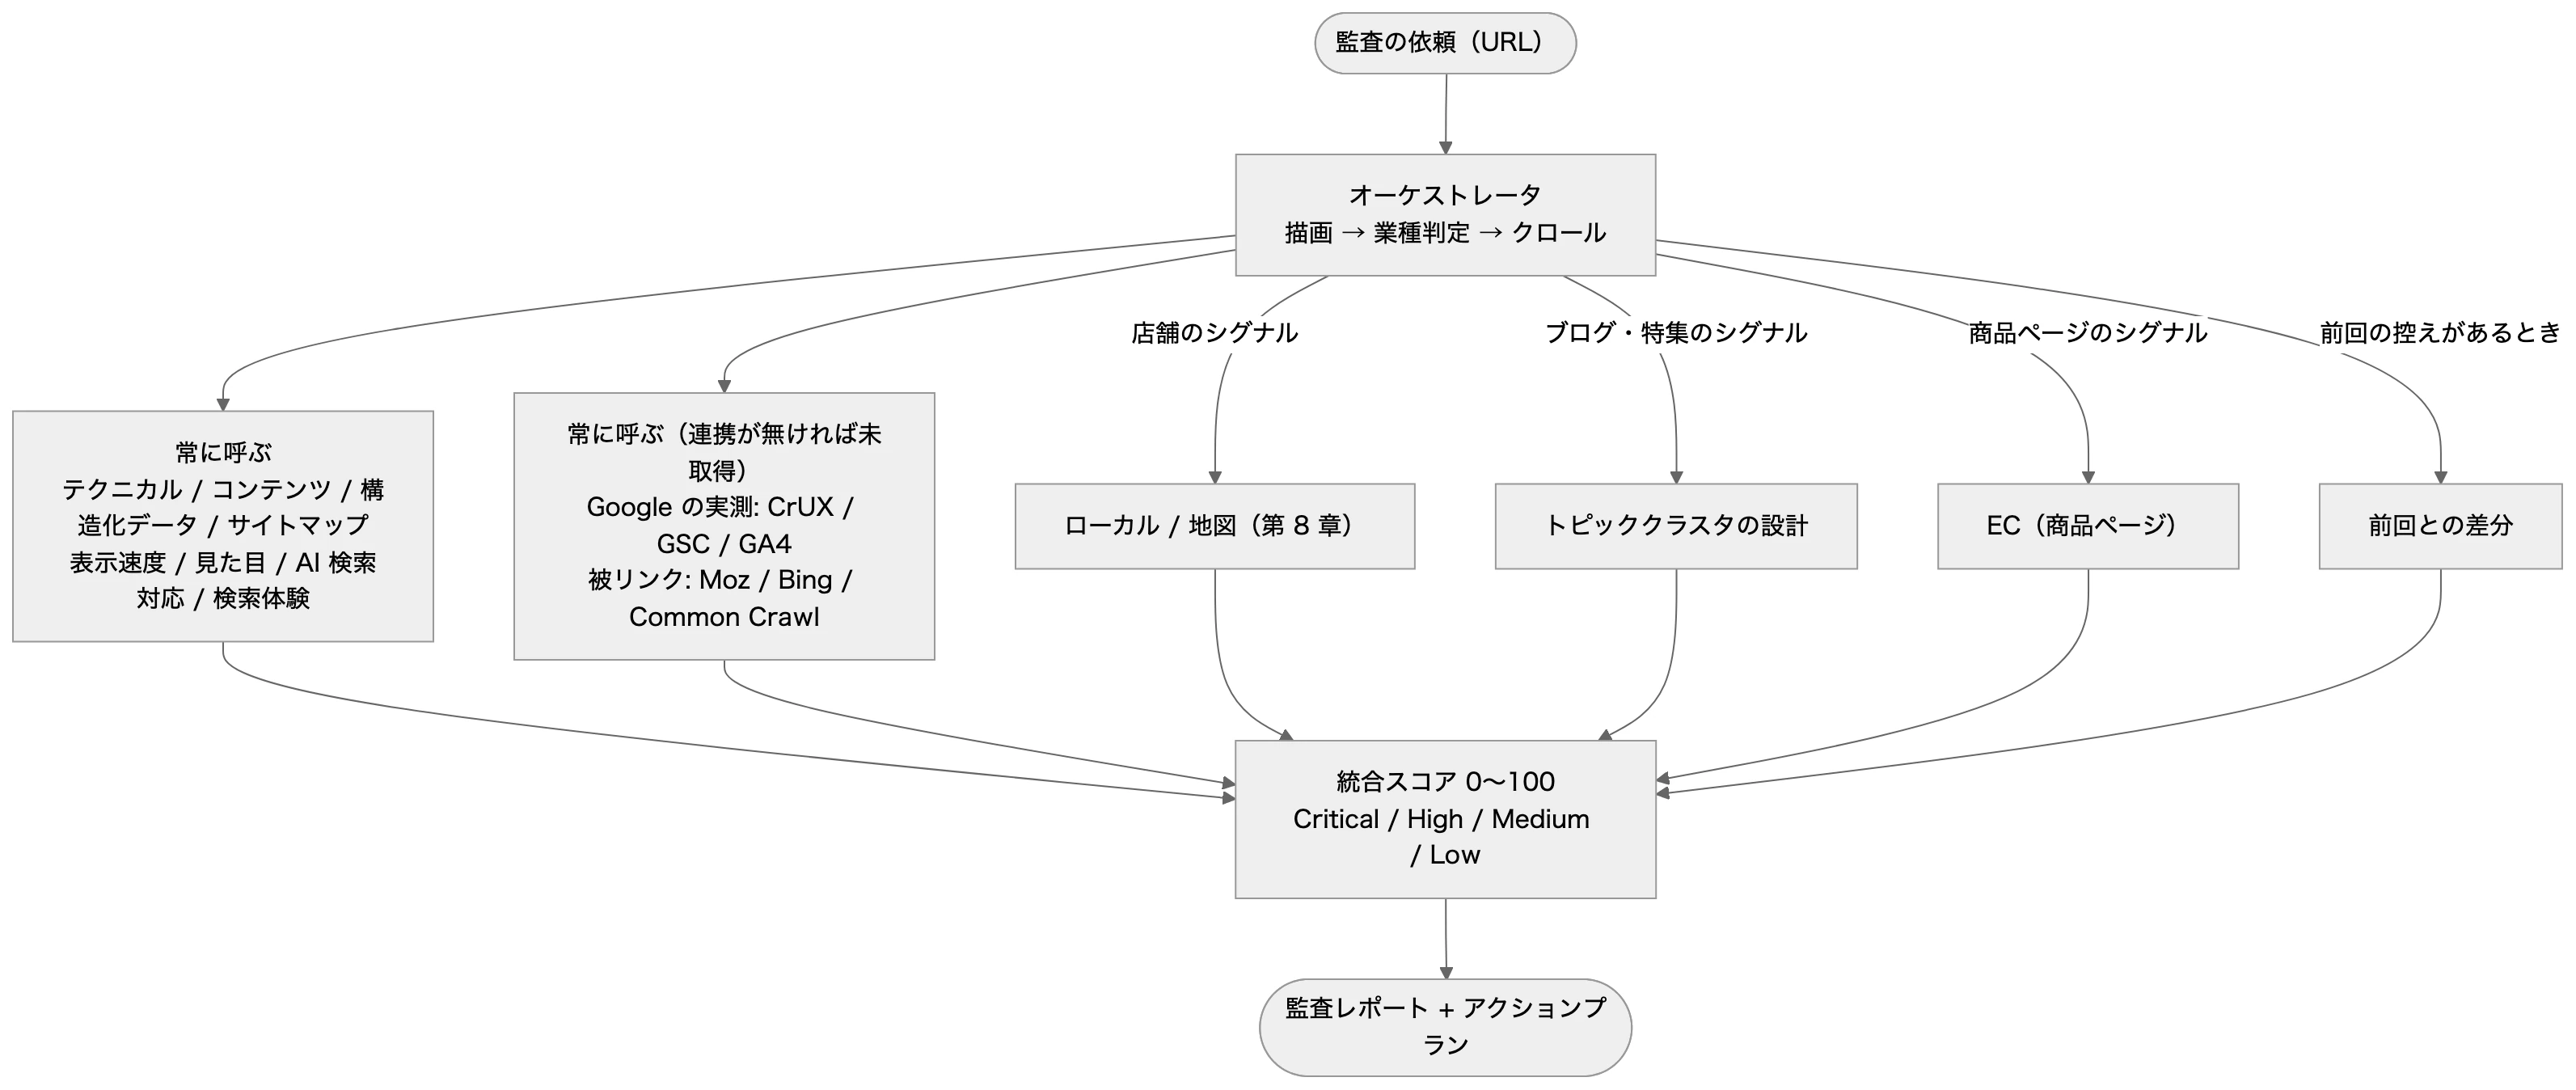
図は横にスクロールできます。図を原寸で開く
図の元になった mermaid を見る
flowchart TD
  IN(["監査の依頼(URL)"]) --> ORCH["オーケストレータ<br/>描画 → 業種判定 → クロール"]
  ORCH --> ALWAYS["常に呼ぶ<br/>テクニカル / コンテンツ / 構造化データ / サイトマップ<br/>表示速度 / 見た目 / AI 検索対応 / 検索体験"]
  ORCH --> GOOG["常に呼ぶ(連携が無ければ未取得)<br/>Google の実測: CrUX / GSC / GA4<br/>被リンク: Moz / Bing / Common Crawl"]
  ORCH -->|"店舗のシグナル"| LOCAL["ローカル / 地図(第 8 章)"]
  ORCH -->|"ブログ・特集のシグナル"| CLUSTER["トピッククラスタの設計"]
  ORCH -->|"商品ページのシグナル"| EC["EC(商品ページ)"]
  ORCH -->|"前回の控えがあるとき"| DRIFT["前回との差分"]
  ALWAYS --> SCORE["統合スコア 0〜100<br/>Critical / High / Medium / Low"]
  GOOG --> SCORE
  LOCAL --> SCORE
  CLUSTER --> SCORE
  EC --> SCORE
  DRIFT --> SCORE
  SCORE --> OUT(["監査レポート + アクションプラン"])
入口を増やさないのがコツです。日本語で運用する改善の PDCA(現状把握 → 施策バックログ → 実行 → 効果測定)の入口を 1 つ置き、英語圏由来の専門担当は「委譲でしか動かない」と本文に注記しておきます。同じ依頼でどちらが立つか決まらない状態を放置すると、成果物の形が実行ごとに変わり、先月と比べられません。第 2 章のとおりスキルは自動では立たないので、「やりたいこと → 呼ぶもの」の表を実行者に渡します。
入口と委譲先の書き分けは、SKILL.md の description で行います。次は入口のスキルの骨子です。自分で診断はせず、委譲に要る下ごしらえと、所見を 1 つにまとめる仕事だけを持ちます。
---
name: site-audit
description: >-
  サイト全体の SEO 監査の入口。URL を受け取り、描画・業種の見立て・クロールを
  行ったうえで専門の担当へ委譲し、統合スコアとアクションプランを返す。
  「SEO 監査をして」「サイト全体を診断して」「検索に弱い理由を洗い出して」で使う。
  ※1 ページだけの診断は記事診断のスキル、SEO の改善を継続して回す依頼は
  SEO 改善ワークフロー、順位だけ知りたい依頼は順位計測のスキルへ。
---
# サイト全体の SEO 監査

## 手順
1. トップページを描画し、業種(店舗 / EC / メディア / SaaS / 代理店)を見立てる
2. robots.txt を読んでから、上限ページ数までクロールする
3. 次の担当へ委譲する(どの担当も、自分では入口にならない)
   - 常に: テクニカル / コンテンツ / 構造化データ / 表示速度 / AI 検索対応
   - 常に: Google の実測(CrUX・Search Console・GA4)。連携が無ければ「未取得」で返る
   - 店舗のシグナルがあるとき: ローカル
   - 前回の控えがあるとき: 前回との差分
4. 各担当の所見を、固定の重みで 0〜100 の統合スコアにまとめる

## 縮退先
- 連携が 1 つも無くても監査は成立させる。取れなかった項目は理由つきで「未取得」と書く
- 被リンクで参照ドメインの一覧が取れないときは、スコアを出さず「データ不足」と書く

## 出力
- 一言でいうと(3 行)/ 統合スコアと内訳 / Critical・High・Medium・Low の所見 / アクションプラン
- 各所見に、根拠(URL と実測値)と取得経路を付ける
入口の手順書は「振り分けてまとめるだけ」に切りました。入口を増やさないためです。診断の中身を入口にも持たせると、同じ依頼で入口と担当のどちらが立つか決まらず、成果物の形が実行ごとに変わって先月と比べられません。description の末尾で 1 ページの診断・継続の改善・順位だけの依頼を別のスキルへ送るのも、同じ理由からです。手順の 3 には「どの担当も、自分では入口にならない」と書き、担当の側の description にも同じことを書いています。入口の側にだけ書いても、担当の description が「診断」の語で引かれれば、担当が直接選ばれてしまうからです。
手順の 3 で Google の実測を「常に」呼ばせ、鍵の有無を先に確かめさせないのは、読めるかどうかは叩かないと分からないからです。鍵があっても、プロパティ側で権限が無ければ読めません。ツールをそのまま呼べば、取れないときは「未取得」と対処法が返り、それが確認結果になります。縮退先の「連携が 1 つも無くても監査は成立させる」はこの裏返しで、連携を前提にすると、繋ぎ込みの済んでいない案件で成果物がゼロになります。被リンクで一覧が取れなければ点数を出さない規則もあります。鍵なしで返るのはドメイン単位の指標までで、「返らない」を 0 件と読むと、データが無いだけのサイトが「被リンクが弱い」と読まれてしまいます。手順の 4 の重みを固定にしたのは、値そのものより、実行ごとに変えないことのほうが効くからです。出力で所見ごとに取得経路を付けさせるのは、実測から出た所見と「未取得」を補った所見を、読む人が見分けられるようにするためです。
委譲される側の description には、単体では起動しないことと、日本語の入口がどれかを書きます。
---
name: technical-seo-check
description: >-
  クロール可能性・インデックス可能性・URL 構造・モバイル対応・JavaScript 描画を
  診断する担当。サイト全体監査の入口からの委譲で使う。単体では起動しない。
  「SEO 監査をして」と頼まれたときの入口はサイト全体監査、日本語での改善の相談なら
  SEO 改善ワークフローが入口。
---
この担当の手順書は description だけを示しています。取り違えを防ぐ仕掛けは description にしか置けないからです。「単体では起動しない」の 1 文が無いと、「サイトを診断して」という依頼でこの担当が直接選ばれることがあります。その場合に返ってくるのは、統合スコアの無い、テクニカルの所見だけのレポートです。先月の監査結果とは形が違うので、比べられません。入口を 2 つ名指ししているのは、入口が実際に 2 つあるからです。英語圏由来の担当を呼ぶのはサイト全体監査、日本語で改善を相談する人の入口は SEO 改善ワークフローで、依頼の言葉が違います。どちらから来ても、この担当は同じ形の所見を返します。
入口の description で振り先にした「1 ページだけの診断」も、入口を分けて骨子を持っておきます。
---
name: single-page-seo
description: >-
  1 ページを、オンページ要素・本文の質・メタタグ・構造化データ・画像・速度の
  順に通しで診る。
  「このページを見て」「1 ページだけ診断して」で使う。
  ※日本語記事のリライト指示書は記事監査のスキル、CVR の観点は LP 改善のスキル(第 4 章)。
---
# ページ診断

## 手順
1. このページが狙う語と、上位に並んでいる形を確かめる
2. 上から順に点検し、指摘に**直す手間の目安**を付ける
3. 上位 3 つに絞って出す(全部出すと誰も動かない)

## 出力
現状 → 指摘(重大度・手間)→ 直す順番 → 直した後の確かめ方
1 ページの診断をサイト全体監査から切り離したのは、返すものが違うからです。全体監査は数百ページをクロールして統合スコアを出しますが、1 ページを見てほしい人が要るのは、そのページを直す順番です。指摘が 40 件並んだレポートでは、手を動かす人はどれからやればよいか分かりません。そこで手順の 2 で指摘に直す手間の目安を付けさせ、手順の 3 で上位 3 つに絞らせています。手間が書いてあれば、限られた時間でどこまで直すかを店長やディレクターが決められます。手順の 1 で狙う語と上位の形を先に確かめさせるのは、ページの種類が検索結果と合っていなければ、中身を直しても入れないからです(後の「ページの形を検索結果に合わせる」の節)。日本語記事のリライト指示書と CVR の観点を description で別のスキルへ送っているのは、同じページでも見る材料が違うため。SEO の入口と CVR の入口は分けます。
「読めるか」は叩いて確かめる
委譲先の手順書に「先に鍵の有無を確認してから動け」と書きたくなります。これは逆効果でした。鍵があっても、プロパティ側で権限が付いていなければ読めないからです。ツールをそのまま呼び、取れなければ「未取得」と対処法が返る形にしておけば、その返答がそのまま確認結果になります。監査は連携がゼロでも成立し、取れなかった項目は理由つきで「未取得」と書かれるだけです。
被リンクはとくに慎重に扱います。鍵なしで取れるのはドメイン単位の指標(Common Crawl のウェブグラフ)までで、参照ドメインの一覧は返ってきません。「返らない」を「0 件」と読まないこと。データのある要因が少なければ、数値のスコアを出さず「データ不足」と書きます。
著者が開発しているマーケティングエージェントでは、サイト全体監査の入口を 1 つに固定し、テクニカル・コンテンツ・構造化データ・表示速度・AI 検索対応・被リンク・検索体験の各担当は、その入口からの委譲でしか動かないようにしています。日本語運用の PDCA には別の入口を 1 つ置き、「既存記事を直すなら記事監査の担当、CVR の観点なら CRO の担当、順位は順位計測の担当、Search Console の取得はデータ取得の担当(判断は流入分析の担当)」という取り違え表を実行者に渡しています。統合スコアの重みは、テクニカル 22%・コンテンツ 23%・オンページ 20%・構造化データ 10%・表示速度 10%・AI 検索対応 10%・画像 5% です。重みの値そのものより、重みを 1 箇所に書いて実行ごとに変えないことのほうが効きます。
変更で壊していないかを見張る
監査は 1 回で終わりではありません。サイトの改修やテンプレートの差し替えで、タイトル・canonical・noindex・構造化データが、担当者の気づかないうちに変わることがあります。監査のたびに主要ページの「正常な状態」を控えておき、次の回に差分を取ります。控える項目は、タイトル・メタディスクリプション・canonical・robots の指定・見出し・構造化データ・HTTP ステータス・表示速度の実測です。
差分には重大度を付けます。noindex が付いた・canonical が別の URL を指した・ステータスが 404 になった、は即時対応。タイトルや見出しの変更は 1 週間以内に確認。文言の軽微な変更は記録だけ。改修のたびに全部の差分を同じ重さで人に読ませると、重要な 1 件が他の変更と一緒に並び、見落とされます。
この見張りを手順書にしたものです。控えを取って差分を出すだけで、壊れを直すところまでは持ちません。
---
name: seo-drift-watch
description: >-
  主要ページの「正常な状態」を控え、次の回に差分を取って壊れを見つける。
  「改修で壊れていないか見て」「デプロイ後のチェック」「前回と比べて」で使う。
---
# 変更の見張り

## 控える項目
タイトル / 説明文 / 正規 URL / 登録の可否の指定 / 見出し / 構造化データ /
HTTP の状態 / 表示速度の実測

## 手順
1. 前回の控えを**外の永続先**(過去の成果物・記録シート)から読み直す。
   無ければ「今回が基準。差分は次回から」と先頭に書く
2. 差分に重大度を付ける:登録拒否・正規 URL の変更・404 は即時。
   タイトルと見出しは 1 週間以内。文言の軽微な変更は記録だけ
3. 今回の状態を、次回の基準として成果物に残す

## やらないこと
- 全部の差分を同じ重さで人に読ませない(重要な 1 件が埋もれる)
控えと差分だけの手順書にしたのは、見張りが監査と別の周期で動くからです。全体監査は初回や四半期の見直しで行いますが、改修やテンプレートの差し替えはその間に何度も起きます。この依頼をする人は、SEO の言葉ではなく作業の言葉で頼みます。description の言い方が「改修で壊れていないか」「デプロイ後のチェック」なのはそのためです。作業のたびに作業用のフォルダが新しくなる環境では、前回のファイルは残っていません。だから手順の 1 では、前回の控えを外の永続先から読み直させます。控えは成果物の本文に書き出し、次の回はそこから読みます。控えが無いときに「今回が基準。差分は次回から」と先頭に書かせるのは、比べる相手が無いのに「変更なし」と返ると、壊れていないと読まれるからです。手順の 2 で重大度を 3 段に固定したのは、全部の差分を同じ重さで人に読ませると、noindex の 1 件がタイトルの文言の変更と一緒に並んで見落とされるからです。どの変更を即時にするかは案件で変わらないので、依頼文ではなく手順書に置きました。
データを取る——Search Console と GA4
Search Console API で取れるもの
Google Search Console(GSC)は、自社サイトが検索結果にどう出たかを Google が教えてくれる公式ツールです。API で取れるものは 3 つ。検索パフォーマンス(クエリ別・ページ別のクリック・表示回数・CTR・平均掲載順位)、URL 検査(Google がその URL をどう認識しているか)、サイトマップの一覧と送信です。検索パフォーマンスは期間と集計の軸(ディメンション)を指定して取ります。パラメータ名は執筆時点の公式リファレンスのものです。
{
  "startDate": "2026-07-11",
  "endDate": "2026-08-07",
  "dimensions": ["query", "page"],
  "rowLimit": 500,
  "dataState": "final"
}
戻りの各行はクリック・表示回数・ctr・position を持ち、ctr は 0〜1 の比率で返ります。地味な 1 点ですが、これが後で効いてきます。
読み方の注意は 5 つあります。確定まで 2〜3 日かかるので、直近 1〜2 日の 0 は評価に使わず、終了日の既定を 3 日前にしておく。行数で切った合計はサイト全体の合計ではないので、全体はディメンションを空にして 1 行で取る。期間比較は前期の日付で同じ呼び出しをもう 1 回して突き合わせ、日付ディメンションと混ぜない。データは約 16 か月で消えるので、確定した月次分は退避しておく。URL 検査には 1 日あたりの上限があり(執筆時点でプロパティごとに 2,000 件)、対象を絞ってから渡す。どれも知っていれば避けられ、知らなければエラーも出ないまま数字が狂う類のものです。
取得だけを受け持つ担当の骨子です。どのキーワードを直すかの判断は、description で別のスキルへ振っています。
---
name: search-console-data
description: >-
  検索の実績(クリック・表示回数・CTR・掲載順位)、URL の登録状況、サイトマップを取る。
  「サーチコンソールのデータを取って」「クエリ別の実績」
  「この URL は登録されているか」で使う。
  ※どのキーワードをテコ入れするかの判断は流入分析のスキル、
  実際の検索結果の順位は順位計測のスキル。
---
# 検索実績の取得

## 手順
1. プロパティを一覧から選ぶ(手入力させない。形式の違いで 403 になる)
2. 期間・粒度(クエリ / ページ / 国 / デバイス)・件数の上限を先に決める
3. 取った値はそのまま渡す。**CTR は 0〜1 の生値**なので、表示する側で 1 回だけ % に直す
4. 取れなければ「連携が未設定」と対処法を返す(0 で埋めない)

## やらないこと
- 直近 2〜3 日の未確定値を評価に使わない
- サイトマップの送信は外部反映なので、承認を通す
取得だけの手順書を 1 つ置いたのは、取得経路を 1 本にするためです。流入分析も、順位計測の縮退先も、監査で呼ぶ Google の実測も、検索の実績が要る手順書はすべてここを通ります。経路が 2 本あると、単位や期間の解釈がずれたときにどちらが正しいか判定できません。手順の 3 で「CTR は 0〜1 の生値のまま渡し、% に直すのは表示する側で 1 回だけ」としているのもそのためで、経緯は次の節で述べます。判断はこの手順書に入れていません。候補の条件は流入分析の側の 1 箇所に持たせ、取得の側は呼ばれ方によって値を変えないようにします。
手順の 1 でプロパティを一覧から選ばせるのは、ドメインプロパティと URL プレフィックスの取り違えが権限不足と同じ 403 で返り、切り分けられないからです(後の「プロパティはサイトに属する。手入力させない」の節)。行数で切った合計はサイト全体の合計ではなく、URL 検査には 1 日の上限もあります。手順の 2 で期間・粒度・件数の上限を先に決めさせているのはそのためです。どれも知っていれば避けられ、知らなければエラーも出ないまま数字が狂うので、依頼する人が毎回思い出さなくてよいように手順書の側に置きました。手順の 4 で 0 で埋めさせないのは、0 が「成果ゼロ」と読め、連携が壊れていることに誰も気づけなくなるからです。やらないことの直近 2〜3 日の未確定値も、同じ性質の規則。サイトマップの送信だけは承認に通すと書きました。取得と同じ API にある唯一の外部反映で、読み取りの手順書の中から承認なしに届く経路を残さないためです。
単位は経路ごとに確定させる
同じ「CTR」でも、Search Console の API は 0〜1、Meta 広告の API はパーセントで返します。ここで「値が 1 以下なら比率」のような推測分岐を書くと何が起きるか。実 CTR 0.8% は 1 以下なので比率と判定され、80% として表示されます。取得経路は 1 本にし、変換は画面に出す直前の 1 箇所でだけ行います。
著者は当初、手元の CLI(公開しています)とサーバー同梱のスクリプトの 2 経路で GSC を取っていました。片方は生値、片方はパーセント。どちらで取れたかで数字が 100 倍ずれていたのです。CLI は手元の日次業務にはいまも便利ですが、サーバーの中で AI に使わせる経路からは外しました。鍵を AI に渡さないためと、「画面の数字」と「AI の言う数字」を同じ実装から出すためです。2 本あると、食い違ったときにどちらが正しいか誰にも判定できません。
手元で使う分のコマンドを挙げておきます。日次の確認と、レポートの材料を CSV で落とすところまでは、これで足ります。
go install github.com/trip-clear/search-console-cli/cmd/gsc@latest
gsc auth login                 # 認可する(gsc auth status で状態を見る)
gsc sites list                 # 見えるプロパティを確かめる

gsc query -d query -l 50 --compare previous                      # クエリ別・前の期間との比較
gsc query -d page --preset last_month -o csv --bom > pages.csv    # ページ別を CSV で
gsc query -d query -f page~~/blog/ -l 200                        # /blog/ 配下だけに絞る
gsc inspect https://example.com/blog/post-1                      # インデックス状況を 1 URL ずつ
--bom を付けるのは、書き出した CSV を表計算ソフトで開いたときに文字化けしないようにするためです。gsc sites list を先に叩くのは、プロパティの表記を手で打たせないためで、すぐ下の節の話につながります。ただし、このコマンドをエージェントに実行させる手順書は書きません。 鍵は認可したときに PC に保存されるので、ターミナルを使えるエージェントはそれをそのまま使えます(第 2 章)。人が画面を見ながら使う道具と、エージェントに使わせる道具を分ける、というのがここでの結論です。
この節の規則は、エージェントへの依頼文にもそのまま書きます。Search Console の実績から改善候補を出してもらう依頼を、足りない例と十分な例で比べてみます。まず足りない例です。
サーチコンソールを見て、改善したほうがいいキーワードを教えて。期間もプロパティも決まっていないので、終了日が今日になり、確定していない直近 2 日の値が混ざります。CTR の単位を指定していないため、表に 0.03 のまま出るか、途中で 100 倍されて 3% と 300% が同じ列に並ぶこともあります。候補を選ぶ条件も実行ごとに変わるので、先月の結果と比べられません。データが読めなかったときは、一般論の改善策だけが返ってきます。
駅前の美容室のサイト(Search Console のドメインプロパティ)について、
検索流入の改善候補を出してください。

- 期間: 直近 28 日。終了日は今日ではなく 3 日前にしてください(直近は未確定のため)
- 比較: 同じ長さの前の期間を、同じ条件でもう 1 回取得して突き合わせてください
- 取得の軸: クエリ×ページ、クエリ別、ページ別、全体合計(軸なしの 1 行)の 4 つ
- CTR の単位: Search Console の ctr は 0〜1 の比率で返ります。
  表では 100 倍してパーセントで出し、列名に「CTR(%)」と書いてください。
  換算はこの 1 回だけにしてください
- 候補の条件:
  1. あと一歩: 平均掲載順位 11〜20 位で、表示回数が全クエリの上位 3 割
  2. クリック率: 10 位以内なのに、その順位の目安 CTR の 6 割に届かない
  3. 順位下落: 前期より 3 位以上落ちた
  4. 守るリスト: クリック数が上位 1 割のクエリ(リライトで消さないため)
- 各候補に、根拠の行(クエリ・ページ・順位・表示回数・CTR・クリック)を付けてください
- Search Console が読めなかった場合は、数字を推測で埋めず「未取得」と書き、
  理由と、こちらで何をすれば取れるかを書いて終えてください
- 読み手は店長です。冒頭に「一言でいうと」を 3 行で置いてください
- サイトの変更やサイトマップの送信はしないでください(今回は調べるだけです)
この依頼文のうち、案件ごとに変わるのは、対象のプロパティ・期間の長さ・読み手・「今回は調べるだけ」という範囲で、これらは依頼文に残ります。案件が変わっても同じなのは、終了日を 3 日前にすること・CTR の換算を 1 回にすること・候補の 4 条件・読めなかったときの書き方です。毎月使うようになったら、この 4 つを手順書へ移します。終了日と単位と読めなかったときの扱いは取得の手順書(前の骨子)に、候補の条件と守るリストは次の判断の手順書に入ります。
移した先の手順書は、たとえば次のようになります。
---
name: inflow-analysis
description: >-
  検索実績から、テコ入れすべきキーワードとページを特定する。
  「流入分析をして」「CTR が低いキーワード」「リライト候補を探して」で使う。
  ※データの取得は検索実績のスキル。このスキルはその上の判断。
---
# 流入の分析

## 手順
1. 期間を 2 つ取る(今回と前回。季節性があれば前年同期も)
2. 3 つの群に分ける:**あと少しで上位**(掲載順位 11〜20 位)/
   **表示は多いが押されていない**(CTR が低い)/ **下がっている**
3. 群ごとに打ち手を分ける(本文を足す / タイトルと説明を直す / 原因を切り分ける)
4. 直す前に、クリック上位 1 割の語を「守るリスト」に控える

## 守ること
- 件数の少ないキーワードの CTR を率で断定しない(分母を一緒に書く)
- 順位の変化と施策の実施日を並べてから因果を語る
この手順書は取得を持たず、判断だけを持ちます。候補を選ぶ条件が実行ごとに変わると先月の結果と比べられない、というのが足りない依頼文で起きたことでした。条件を手順書に固定すれば、依頼文に条件が無い月でも同じ基準で候補が出ます。手順の 2 の 3 つの群は、後の「アドバイザー」の節で機械的に出す 3 つの型と同じ切り方です。同じ切り方にしておくと、人が読む分析と機械が毎日出す提案が別のことを言いません。
手順の 4 で守るリストを直す前に作らせるのは、クリック上位の語を含む見出しをリライトで消すと、いまの流入を支えているものを失うからです。守ることの「件数の少ないキーワードの CTR を率で断定しない」にも理由があります。表示回数が数件の語では率が 1 件の増減で大きく動き、率だけを見ると候補に見えてしまいます。分母を並記させれば、読む人が自分で割り引けます。「順位の変化と施策の実施日を並べてから因果を語る」は、後の「流入が落ちたときの切り分け」の節の規則です。季節性・計測の変化・サイトの変更を外す前に因果を書くと、たまたま重なった変更が効いたことになり、根拠の無いやり方が次の施策の手順に入り込みます。
候補を拾う段だけを切り出した担当も置いておくと、記事の構成案を作るときにも同じ基準で候補を呼べます。
---
name: gsc-quick-ops
description: >-
  検索実績から、手を入れる価値の高い候補を短時間で拾う。
  「あと少しで上位の語を出して」「落ちている語を教えて」で使う。
  ※単体では起動しない。流入分析や記事構成のスキルから呼ぶ。
---
# 検索実績の軽い洗い出し

## 出すもの(これだけ)
- あと少しで上位:掲載順位 11〜20 位で表示回数の多い語
- 落ちている語:前期間比でクリックが減った語(減少幅と件数を並記)
- 伸びている語:直近で表示回数が増えた語

## やらないこと
- ここで施策を決めない(候補を出すまで。判断は流入分析のスキル)
候補を拾う段を別の手順書に切り出したのは、呼ぶ側が 2 つ以上あるからです。流入分析も記事の構成案も同じ候補を使いますが、拾い方を各手順書に書くと、片方だけ直したときに基準がずれます。description に「単体では起動しない」と書くのはテクニカルの担当と同じ理由で、「落ちている語を教えて」で直接立つと、守るリストも打ち手も無い語の一覧だけが返ります。施策を決めることは、やらないことに入れました。判断を流入分析の 1 箇所に集めるためです。落ちている語には、減少幅と件数を並記させます。件数の無い減少率は、数件しか無い語ほど大きく見えるからです。
GA4 で取れるもの
Google Analytics 4(GA4)はサイトに来た人の行動を計測するツールで、Data API でレポートを取ります。要るのは日別のセッション・ユーザー・CV と、ランディングページ別のセッションくらいのものです。自然検索だけ見るなら流入チャネルで絞ります。CV は GA4 の「キーイベント」の数です(旧称コンバージョン。2024 年に改称)。
落とし穴は 3 つ。当日〜前日は暫定値であること。しきい値が効くと少数セグメントの値が伏せられること。GA4 側でキーイベントを 1 つも定義していなければ、連携が正常でも CV は 0 のままであること。最後の 0 は本当の 0 ですが、原因は連携ではなく計測設計にあります。画面にはそう書き添えます。
プロパティはサイトに属する。手入力させない
Search Console のプロパティには 2 種類あります。ドメインプロパティ(sc-domain: の後ろにドメインを続ける形)と URL プレフィックス(https から始まる URL で、末尾のスラッシュが必須)で、別物です。取り違えると 403 が返りますが、権限不足のときと同じ 403 なので切り分けられません。GA4 でいちばん多い失敗は、プロパティ ID(9 桁程度の数字)の代わりに測定 ID(G- で始まるタグ用の ID)を入れることで、これも 403 です。だから識別子は手入力させません。連携したアカウントで一覧を取って選ばせ、選んだ時点で保存します。一覧が取れないときだけ手入力に落とします。
プロパティの持ち主は案件ではなくサイトです。1 案件が複数のサイトを持つので、両プロパティも追跡キーワードもサイト単位で持ち、サイトの ID は振り直しません。順位スナップショットの主キーだからです。
OAuth クライアントは 1 つ、コールバックは 1 本
読み取りは、利用者の Google アカウントに許可をもらう OAuth の認可コードフローで行います。案件ごとにクライアントを作らせる設計は、3 つの理由で行き詰まりました。1 つのクライアントに登録できるリダイレクト URI に上限があること。審査の単位がクライアントではなく Google Cloud プロジェクトであること。Drive のようなスコープの有無で二本立てになり、どちらで認可したかを持ち回ることになること。クライアントはサービス全体で 1 つ、コールバック URL は固定 1 本にし、保存先は URL ではなく署名つきの state から引きます。トークン交換には state に載せた redirect_uri をそのまま使います。設定から組み立て直すと書き方の差でずれ、redirect_uri_mismatch で落ちます。代理店運用なら、自社のアカウントで同意し、クライアント企業には Search Console の「ユーザーと権限」と GA4 の「アクセス管理」でそのアカウントを追加してもらえば済みます。Google Cloud を触らせずに済むのが、この形のいちばんの利点です。
スコープは機能ごとに出し分けます。既定は Search Console と GA4 だけで、Indexing API や Google 広告は使う案件だけが追加で同意します。追加同意で既存の同意を消さない指定を付け忘れると、「Indexing を足したら GA4 が落ちた」が起きます。保存するスコープは要求内容ではなく、トークン応答が返した実際の付与内容です。同意画面は項目ごとに外せるので、要求と付与はずれえます。もう 1 つ、制限付き(restricted)に分類されるスコープを 1 つでも足すと審査に年次の第三者セキュリティ評価が加わります(Google の検証要件)。同意画面は Google Cloud プロジェクトに 1 枚しかないので、クライアントを分けても逃げられません。Drive の読み取りが要る案件はサービスアカウント鍵で賄います。
サービスアカウントだけでは足りない。テスト状態のまま運用しない
サービスアカウントは、人ではなく機械に発行する Google アカウントです。鍵を登録すれば認証は通ります。ところが Search Console も GA4 も Google Cloud の IAM ロールでは見えず、プロパティ側でそのアドレスをユーザーとして追加して初めて読めます。鍵の登録は「ファイルをアップロード」を第一手段にし、値を写させません。手で写すと打ち間違いが起きますし、秘密がクリップボードと会話履歴に残る理由もありません。OAuth クライアントの JSON を投げてくる人は必ずいます。そのとき「不正な JSON」ではなく、「何を投げたのか、代わりに何をすればよいか」を返します。
同意画面の公開状態を「テスト」のまま運用に入ってはいけません。テスト状態で発行された refresh_token は 7 日で失効します(Google の OAuth 2.0 ドキュメント)。「一度は繋がったのに翌週 401」という、いちばん切り分けづらい壊れ方をします。未審査でも「本番」に公開すれば、警告は出ますが運用できます。
「鍵がある」と「読める」は別
画面に出す接続状態は、実際に叩いた結果から作ります。認可したときの記録(スコープ・アカウント名・日時)は、鍵が消えても失効しても残るからです。そこを根拠にした画面が実際にどうなったか。「接続状況は未設定なのに、許可する範囲だけ 3 つとも連携済み」という、どちらが本当か読めない表示になりました。記録を使ってよいのはチェックボックスの復元だけです。一度は繋いだ人には「未設定」とだけ出さず、何をすれば直るかを添えます。
| 症状 | 原因 | 対処 |
|---|---|---|
| 連携は通るのに取得だけ 403 | 同意したアカウントにそのプロパティの権限が無い | Search Console / GA4 側でユーザーに追加する |
| 翌週になって 401(invalid_grant) | 同意画面がテスト状態でトークンが 7 日で失効した。または連携が取り消された | 同意画面を本番に公開し、連携し直す |
| 連携したのに数字が「—」 | 見るプロパティを選んでいない | 連携し直す必要は無い。一覧から選ぶ |
| GA4 だけ 403 | 測定 ID を入れている | プロパティ ID を一覧から選び直す |
| CV だけ 0 | GA4 側にキーイベントが無い | 予約完了・問い合わせ送信などをキーイベントに定義する |
| redirect_uri_mismatch | 戻り先 URL の登録と実際の値が食い違う | 利用者側では直せない。文面を添えて運営へ |
連携の完了は別タブで起きます。放っておくと元の画面は「未設定」のままで、「接続を確認」を押す必要があると知っている人しか先へ進めません。完了した側から元の画面へ通知を流し、成功したタブだけ自動で閉じます。通知だけに頼らず「タブに戻ってきた」でも取り直し、どちらが先に来ても 1 回だけ動かします。取り直すのは鍵の状態だけではなく、連携先の一覧もです。捨てないと、別アカウントで連携し直しても前のアカウントの候補が残り続けます。
筆者の環境では、連携の状態を 2 つのバッジに分けています。「連携済み / 未設定」は鍵の有無、「接続確認 OK / NG」は押したときの実測で、片方だけでは判断できない形です。取れなかった数字は 0 ではなく「—」で出します。0 で埋めると「成果がゼロ」と読め、連携が壊れていることに誰も気づけません。この節の内容は、利用者向けの手順書にも同じ順序で書いています。繋ぎ込みを担当するのは、ダッシュボードに入れない情シスや代理店の担当者であることが多く、そのまま渡せる文書にしておく価値があります。
順位を測る
順位に見えて順位ではない数字
Search Console の「平均掲載順位」は、表示されたときの順位の平均で、全クエリにまたがります。狙ったキーワードで何位かを知るには、実際の検索結果を開いて数えるしかありません。2 つは数え方が違うので値は一致しませんし、どちらかが壊れているわけでもありません。画面に両方出すなら見出しで区別します。
Google 広告のキーワードプランナー(Google Ads API)が返すのは、月間平均検索ボリューム・月別の推移・広告の競合性・ページ上部の入札単価です。競合性は広告枠の埋まり具合であって、上位表示の難しさではありません。順位も検索結果も返りません。この API には順位の口がそもそも無いのです。
実 SERP はブラウザが要る——API の中で待たない
検索結果ページ(SERP)を実際に開くにはブラウザが要ります。ブラウザが要る処理は API のリクエストの中に置かず、受理だけ返して外のジョブで実行します。ジョブが取得経路を順に試し、実測が取れなければ Search Console の平均掲載順位へ縮退します。ただし、どの経路で取れたかをスナップショットに記録し、期間の中で経路が変わったら画面に「取得経路が変わっています」と出します。期間平均と実測を同じ折れ線に混ぜると、推移そのものが嘘になるからです。
著者のマーケティングエージェントには、順位取得を API のリクエストの中で動かしていた時期があります。ところが API のコンテナにはブラウザが入っていません。本番でもローカルでも起動に毎回失敗し、エラーを返さずに平均掲載順位へ切り替わっていました。画面には「順位」が出ているので、実測の検索結果が一度も取れていないことに誰も気づけなかったのです。取得をジョブへ出し、経路を記録するように直しました。「別の経路へ切り替えたら必ず記録する」は、ここで学んだ規則です。
実査の作法もあります。データセンターの IP や VPN 経由の回線からは CAPTCHA を返されやすく、ヘッドレスブラウザの既定の指紋もそのまま弾かれます。キーワードの間には数秒の待ちを入れます。速くするほど落ちる、と心得ておくくらいでちょうどよいです。2 回続けて CAPTCHA を踏んだらその回は打ち切り、残りは未取得として縮退先へ譲ります。2 ページ目を読むのは、1 ページ目で自社が見つからなかったときだけです(執筆時点、1 回で返るのは 10 件前後で、件数を増やすパラメータは廃止されています)。同じ案件の取得を同時に走らせるとブロック率が上がるので、案件ごとにジョブを 1 本にしてサイトを順番に取ります。
検索結果の HTML 構造は予告なく変わります。壊れたときに「順位ゼロ」を成功として記録しないよう、通常の結果が数件も取れなければ失敗扱いにします。圏外は平均に混ぜません。0 でも 100 でも嘘になるので、分母は順位の付いた語だけです。AI による概要などの検出は見出し文字に依存してさらに脆いので、欠けても順位は成立する設計にし、画面にも「取りこぼしがある前提で見る」と書いておきます。記録は 1 日 1 行。同じ日に 2 回取ったら後勝ちです。
ここまでの作法を手順書にまとめると、次のような骨子になります。測って記録するだけの手順書で、どのキーワードを追うかは決めず、順位が動いた理由も語りません。
---
name: keyword-rank-tracking
description: >-
  登録済みのキーワードについて、自社サイトの Google 検索順位を実際の検索結果で
  測り、日ごとに記録して前回と比べる。「順位を測って」「何位か確認して」
  「先週から順位はどう変わった」で使う。
  ※検索回数や入札単価はキーワード調査のスキル(順位の代わりには使わない)。
  流入の分析や改善候補は流入分析のスキルへ。
---
# 検索順位の計測

## 手順
1. 計測対象のキーワードとサイトを、登録済みの一覧から読む(その場で作らない)
2. キーワードごとに実際の検索結果を開き、自社の URL が何位にあるかを数える
   - キーワードの間に数秒待つ。同じ案件の取得は 1 本ずつ順番に行う
   - 1 ページ目に無いときだけ 2 ページ目を読む。2 ページ目にも無ければ「圏外」
   - 通常の結果が数件も取れないときは、構造が変わったとみなして失敗扱いにする
3. CAPTCHA が 2 回続いたら、その回は打ち切る。残りのキーワードは縮退先へ回す
4. 1 キーワード 1 日 1 行で記録する。記録には必ず取得経路を入れる
   (実測 / Search Console の平均掲載順位 / 未取得)

## 縮退先
- 実測できなかったキーワードは、Search Console の平均掲載順位を入れる。
  経路の列を「平均掲載順位」にし、実測の値と黙って混ぜない
- それも取れなければ「未取得」。0 位や 100 位で埋めない

## 出力
- キーワード / 今回の順位 / 前回の順位 / 変化 / 取得経路 の表
- 平均順位は順位の付いたキーワードだけで出し、圏外の件数を別に書く
- 期間の中で取得経路が変わったキーワードには、その旨を注記する
この手順書を計測だけに切ったのは、「順位」と呼ばれうる数字が 3 つあり、数え方がどれも違うからです。description の後半では検索回数や入札単価を別のスキルへ振り、「順位の代わりには使わない」と添えました。キーワードプランナーには順位の口がそもそも無いからです。流入の分析を別のスキルへ送るのも、平均掲載順位が全クエリにまたがる平均で、狙った語の順位ではないため。手順の 1 で計測対象を登録済みの一覧から読ませるのは、定点観測の基準が語の一覧そのものだからです。実行ごとに語が変わると、動いたのが順位なのか語なのか読めません。
手順の 4 の「記録には必ず取得経路を入れる」と、縮退先の「実測の値と黙って混ぜない」を重ねて書いているのは、著者が踏んだ壊れ方があるからです。API の中で順位を取っていた時期、ブラウザの無いコンテナで起動に毎回失敗し、エラーを返さずに平均掲載順位へ切り替わっていました。画面には順位が出ているので、誰も気づけませんでした。経路の列が無いと、縮退した日と実測した日が同じ折れ線に並び、順位が動いたのか測り方が変わったのかを区別できません。「0 位や 100 位で埋めない」と、出力で平均を順位の付いた語だけから出させる規則は、圏外の扱いです。圏外を混ぜれば、0 でも 100 でも嘘になります。
手順の 2 と 3 の待ち・順番・CAPTCHA 2 回での打ち切りは、検索結果を実際に開くときの作法で、依頼文に書き忘れた回だけブロックされるので手順書に置きました。「通常の結果が数件も取れなければ失敗扱い」は、検索結果の HTML 構造が予告なく変わるためで、壊れたときに「順位ゼロ」を成功として記録しないための規則です。
何を「順位」と数えるか
実測の順位は、数え方を決めておかないと、測るたびに基準が変わります。著者の手順では次のように決めています。
- 数えるのは通常の検索結果(オーガニック)だけ。広告、AI による概要、店舗の一覧の枠(ローカルパック)、「他の人はこちらも質問」、画像や動画の枠、ショッピング、ナレッジパネルは数えない
- 同じサイトの URL が複数出たら、いちばん上のものを記録する。記録した URL が前回と変わったら注記する。同じキーワードで自社の別のページが入れ替わっているなら、自社のページ同士の食い合い(カニバリゼーション)を疑う
www付きのホストやサブドメインを自社として数えるかを、最初に決めて固定する- 1 回で確かめられた件数が減ったら(10 件までしか見られなかった、など)、「10 位より下」と記録し、「圏外」と混ぜない。取得の条件が変わったことを、黙って推移に混ぜない
- 地域・言語・パーソナライズの条件を固定し、記録に残す。地名を含まない語でも、検索する場所で結果が変わることがある
記録の形は次のようにします。
date,keyword,domain,rank,url,source,note
2026-09-01,温泉旅館 子連れ,yamanoyu.example.jp,8,/plan/family/,実測,
2026-09-08,温泉旅館 子連れ,yamanoyu.example.jp,6,/blog/kids-onsen/,実測,URL が前回と違う
2026-09-15,温泉旅館 子連れ,yamanoyu.example.jp,>10,,実測,確かめられたのは 10 件まで
2026-09-22,温泉旅館 子連れ,yamanoyu.example.jp,7.4,,平均掲載順位,実測できず縮退
2 行目は順位が上がったように見えますが、入っているページが変わっています。3 行目は圏外ではなく、確かめられなかっただけです。4 行目は数え方が違う値なので、グラフでは実測の線とつなげずに別の印で出します。
無料 API で取れるもの、取れないもの
商用の SEO データ API(順位・被リンク・難易度を売るサービス)を契約していない前提で、何がどこまで取れるかを先に確定させます。取れないものは「未取得」と書き、それらしい数字で埋めません。
| API | 取れるもの | 鍵 | 注意 |
|---|---|---|---|
| PageSpeed Insights | Lighthouse のラボ計測と、実利用者の速度データ | 任意だが自動実行には実質必須 | 執筆時点で、実利用者データはこの API から外れ CrUX API へ寄せる方針が示されている |
| CrUX API / History API | LCP・INP・CLS の実測。履歴は週ごとに最大 40 週 | 要 | 利用者が十分にいるサイトにしか値が無い。小規模サイトで空なのは正常 |
| Google Ads API(キーワードプランナー) | 検索ボリューム・月別推移・広告競合性・入札単価 | OAuth + 開発者トークン | 順位と被リンクは無い。null は 0 ではなくデータ無し |
| Bing Webmaster API | Bing 側の検索実績・インデックス・被リンク | 要 | Google の数字ではない。並べて出す |
| Moz Links API | ドメインの権威性指標・参照ドメイン・アンカーテキスト | 要(無料枠は限定) | レート制限が厳しい。信頼度を添えて統合する |
| Common Crawl | ドメイン単位のグラフ指標 | 不要 | 参照ドメインの一覧は返らない。「0 件」と読まない |
Core Web Vitals(LCP は主要コンテンツの表示、INP は操作への応答、CLS はレイアウトのずれ)は実利用者の 75 パーセンタイルで評価します。ラボ計測は再現性の道具で、合否の根拠はあくまで実測です。PageSpeed Insights の鍵は画像生成に使う Gemini の鍵とは別物で、片方を両方に使うと「速度は取れるのに画像生成だけ 403」という、切り分けのできない壊れ方をします。
これらを叩く同梱スクリプトを AI から呼ぶとき、著者は「JSON 出力のときは失敗しても終了コード 0 で、本文に error を入れる」という規約に揃えています。認証エラーでも終了コードが 0 なので、呼ぶ側は必ず本文の error を読むことになります。スクリプトを MCP ツールとして配るなら、この翻訳はゲートウェイの 1 箇所でだけ行い、呼ぶ側は「未取得」のときの理由と対処法だけを読めばよい形にします。
表示速度を取る担当の骨子です。測って並べるだけで、何から直すかは決めません。
---
name: pagespeed-and-crux
description: >-
  ページの表示速度を、検査室の計測と実利用者の計測の両方で取る。
  「表示速度を測って」「Core Web Vitals」「LCP が悪い」で使う。
  ※直す順番の判断はテクニカルのスキル。
---
# 表示速度の計測

## 手順
1. 1 回の実行で、検査室の値と実利用者の値を両方取る
2. **両者を混ぜない**。検査室の値は原因を探す用、実利用者の値は判定用
3. 実利用者の値が返らないページ(訪問が少ない)は「未取得」と書く
4. 推移を見るときは週単位の履歴を使う(単発の値で良し悪しを言わない)

## やらないこと
- 検査室の点数をクライアントへの報告の主役にしない
手順の 1 で検査室の値と実利用者の値を 1 回で両方取らせ、手順の 2 で混ぜさせないのは、役割が違うからです。合否の根拠は実利用者の 75 パーセンタイルで、検査室の計測は原因を探す再現の道具。やらないことで検査室の点数を報告の主役にしないのも、同じ理由です。実利用者の値は、利用者が十分にいるサイトにしかありません。小規模サイトで空なのは正常なので、手順の 3 では返らないページを「未取得」と書かせます。0 や「遅い」に倒すと、訪問が少ないだけのページが速度の問題に見えます。手順の 4 で週単位の履歴を使わせるのは、実測の履歴が週ごとに返るためで、単発の値で良し悪しを言うと、たまたまの週が判定になります。直す順番の判断はテクニカルの担当へ送りました。速度は監査の一部で、他の所見と一緒に固定の重みで並べてから順番を決めるからです。
被リンクを読む——取れる範囲で出し、足りなければ点数を出さない
被リンク(他のサイトから自社サイトへ張られたリンク)は、商用のデータ API を契約していないと全体像が取れない領域です。前の節の表のとおり、無料で取れる情報は情報源ごとに範囲が違います。そこで、どの数字をどの情報源から取ったかを必ず残し、情報源の確かさに応じて扱いを変えます。
情報源ごとに確かさを付けて並べる
| 情報源 | 取れるもの | 確かさの扱い |
|---|---|---|
| リンク元のページを実際に開いて確かめる | 既知のリンクがいまも残っているか | 最も高い。ページそのものを見ているため |
| 被リンクの API(Moz など) | 参照ドメインの一覧・アンカーテキスト・各社独自の権威性やスパムの指標 | 高い。ただし指標は各社の推定値で、Google の評価ではない |
| Bing Webmaster Tools | Bing が把握しているリンクと、競合サイトとの比較 | 中程度。Bing のインデックスの範囲に限られる |
| Common Crawl のウェブグラフ | ドメイン単位の中心性の指標 | 低い。参照ドメインの一覧は返らない |
Bing Webmaster Tools の分は、公開している CLI(bwt)でそのまま取れます。OAuth でなく API キー 1 つで済むので、導入も楽です。
go install github.com/trip-clear/bing-webmaster-cli/cmd/bwt@latest
bwt auth set                                   # API キーを入れる(bwt auth status で確認)
bwt links list                                 # Bing が把握しているリンク元の一覧
bwt links get https://example.com/blog/post-1   # 1 ページに来ているリンク
bwt inspect https://example.com/blog/post-1     # Bing のインデックス状況
bwt crawl issues                               # Bing が見つけたクロールの問題
ここで取れるのは「Bing が把握している範囲」だけです。上の表の確かさが中程度なのはそのためで、件数を被リンクの総数として報告してはいけません。同じ CLI にある bwt submit(URL の送信)は外部反映なので、後の「サイトマップ送信・インデックス送信は外部反映」と同じ扱いにします。
アンカーテキスト(リンクに使われている文言)の偏りや、1 つのドメインからの大量のリンクは、不自然なリンクの手掛かりになります。ただし、どの割合から危ないかを Google は公表していません。スキルに目安の割合を書くなら、ツールの提供元や自社の経験則だと明記します。公式の基準のように報告してはいけません。
要因が揃わなければ点数を出さない
被リンクの状態を 0〜100 点でまとめるなら、要因ごとにデータの有無を数えます。要因は、参照ドメイン数・リンク元の質・アンカーテキストの自然さ・不自然なリンクの割合・リンク元の地域などです。著者の環境では、6 つの要因のうちデータのあるものが 4 つに届かないときは点数を出さず、「データ不足(6 要因中 3 要因)」と書きます。取れなかった要因を 0 点にしないのが要点です。0 点にすると「被リンクが弱い」という別の意味になり、データが無いだけのサイトが悪く見えます。取れない要因は重みを 0 にするのではなく計算から外し、残りの要因で重みを配り直します。
リンク元の確認にも同じ注意が要ります。JavaScript で本文を描画するページや SNS のページは、HTML を取得しただけではリンクが見えません。これを「リンクが消えた」と報告すると誤りになるので、「確認できない」として分けます。
増減は自分で控えを取る
無料の情報源が返すのは、その時点の状態だけです。増えたリンクや消えたリンクの推移は取れないので、依頼されたら「推移の追跡には対応していない」とそのまま答えます。継続して見る案件では、確認した結果を日付つきでレポートに残し、次回の比較の基準にします。初回の結果が基準日になります。作業のたびに作業用のフォルダが新しくなる環境では、ファイルを残しても次回は読めません。結果はレポートの本文に書き出しておきます。
否認(disavow)は最後の手段
不自然なリンクを見つけると、Search Console のリンク否認ツールで無効にしたくなります。Google のヘルプは、使ってよい場面を 2 つの条件を同時に満たすときに限っています。スパム的・人工的・低品質なリンクが相当数あること。そのリンクが手動による対策(Google の担当者が科すペナルティ)を招いた、または招きそうなこと。多くのサイトではこのツールは不要で、誤って使うと検索での評価を下げうる、とも書いています。点検の結果には「否認を推奨」とは書かず、手動による対策の有無と、否認を検討する根拠を並べて、判断を人に残します。
店舗型ビジネスでは、被リンクの数を増やすことより、実際に関係のある組織からのリンクが揃っているかを見るほうが役に立ちます。地域の観光協会・商工会・地域メディア・取引先などです。競合にはリンクしていて自社にはしていないドメインの一覧(リンクギャップ)は、そのまま広報や営業の連絡先の候補になります。
次は被リンクの点検結果の型です。指標ごとに出典を付け、データが足りないときの書き方を固定しています。
site: yamanoyu.example.jp
checked_at: 2026-09-20
health_score: データ不足(6 要因中 3 要因)   # 4 要因に届かなければ点数を出さない
factors:
  - name: 参照ドメイン数
    value: 42
    source: 被リンクの API
  - name: アンカーテキストの自然さ
    value: 宿名での言及が中心。狙った語そのままのリンクは少ない
    source: 被リンクの API
  - name: 不自然なリンクの割合
    value: 未取得
    reason: スパムの指標を返す API の鍵が未設定
  - name: リンク元の地域
    value: 未取得
    reason: リンク元の国を返す情報源に未連携
link_checks:               # 既知のリンクが残っているかを実際に開いて確かめた結果
  - from: https://kanko.example.jp/stay/
    status: 残っている
  - from: https://social.example.com/post/123
    status: 確認できない(JavaScript で描画されるページ)
link_gap:                  # 競合にはあり、自社には無いリンク元
  - https://onsen-guide.example.jp/
  - https://town.example.jp/tourism/
この型で結果を返させる手順書の骨子です。取れる範囲を集めて並べるだけで、否認するかどうかの判断は持ちません。
---
name: backlink-profile
description: >-
  参照ドメイン・アンカーテキスト・有害なリンク・競合との差を、
  無料の取得元を信頼度で重み付けしてまとめる。
  「被リンクを調べて」「参照ドメイン」「リンクの差を見たい」で使う。
---
# 被リンクの整理

## 手順
1. 取得元ごとに取り、**どの元から取った値かを行に残す**
2. 同じドメインの重複を除く
3. 生きているかを実際に見に行く(リンク元が残っているか・rel はどうか)
4. 取れた要因が少なければ**点数を出さず「データ不足」と書く**

## やらないこと
- 「返らない」を「0 件」と読み替えない
- 否認の提案を先に出さない(最後の手段)
「無料の取得元を信頼度で重み付けしてまとめる」形にしたのは、商用のデータ API を契約していない前提で書いているからです。全体像が取れない領域で、どの数字がどの取得元から来たかを落とすと、Bing が把握している範囲の件数が被リンクの総数として報告されます。だから手順の 1 では取得元を行に残させ、確かさの表と突き合わせて読めるようにしています。手順の 3 で実際に見に行かせるのは、それが最も確かな情報源だからです。JavaScript で描画されるページや SNS のリンクを「消えた」と報告しないためでもあります。開いて見えなければ「確認できない」で、消えたとは分けます。
手順の 4 と、やらないことの「返らないを 0 件と読み替えない」は、同じ失敗の 2 つの面です。鍵なしで取れるのはドメイン単位の指標までで、参照ドメインの一覧は返りません。返らない要因を 0 点にすると「被リンクが弱い」という別の意味になり、データが無いだけのサイトが悪く見えます。だから要因が揃わなければ点数を出さず「データ不足(6 要因中 3 要因)」と書き、取れない要因は計算から外して残りで重みを配り直します。否認を先に出さないのは Google のヘルプに沿ったもので、ヘルプは使ってよい場面を 2 条件の同時成立に限り、誤って使うと評価を下げうると書いています。手順書は手動による対策の有無と根拠を並べるまでで、判断は人に残します。増減の追跡を手順に入れていないのは、無料の情報源がその時点の状態しか返さないからです。継続して見る案件では、日付つきの結果を成果物の本文に残し、次回の基準にします。
テクニカルの細部——最初の HTML・多言語ページ・画像・店舗の構造化データ
監査の入口から委譲されるテクニカルの担当が見る項目のうち、自動で点検しやすく、しかも誤った報告が起きやすいものを取り上げます。
重要な指定は最初の HTML で返す
Google は JavaScript を実行してページを描画しますが、最初に受け取った HTML の指定が効く場面があります。JavaScript SEO の基本に書かれている要点は次のとおりです。
- canonical(正規の URL の指定)は HTML で書くのが最善。JavaScript で書き換えるなら、最初の HTML と同じ値にする
- 最初の HTML に noindex があると、描画と JavaScript の実行を省くことがある。JavaScript で noindex を外しても、インデックスされるとは限らない
- 404 など、ステータスが 200 以外のページでは描画を省くことがある
- 構造化データは JavaScript で生成して差し込んでもよい。ただし商品の構造化データを動的に生成すると、ショッピング向けのクロールが少なく不安定になりうる。価格や在庫のように頻繁に変わる情報で問題になる
点検では、最初の HTML と描画後の HTML を両方取り、title・canonical・robots の指定・構造化データが食い違っていないかを比べます。片方だけを見ると、「タグは入っている」と「Google には見えていない」を区別できません。予約ページや物販ページのように、外部のシステムが JavaScript で組み立てるページでは特に食い違いが起きます。
多言語ページ(hreflang)で壊れやすい 5 点
インバウンドの予約を狙う宿や飲食店では、日本語のページと、英語・中国語のページを並べて持つことがあります。検索エンジンに「このページの別の言語版はこれ」と伝える指定が hreflang です。Google のドキュメントにもとづいて、点検する項目を 5 つに分けます。
| 項目 | 規則 | よくある誤り |
|---|---|---|
| 自分自身を含める | 各言語版は、自分自身とすべての別言語版を並べる | 他の言語版だけを並べ、自分を書いていない |
| 相互に指し合う | A が B を指すなら、B も A を指す。片方だけだと両方の指定が無視される | 日本語版だけ更新し、英語版の指定が古いまま |
| 言語と地域のコード | 言語は ISO 639-1、地域は ISO 3166-1 Alpha 2。中国語は zh-Hans(簡体字)・zh-Hant(繁体字)のように文字体系も書ける | 日本語を jp と書く。英国を UK と書く(正しくは GB) |
| 当てはまる言語が無い人の行き先 | x-default で言語の選択ページなどを指すことが推奨されている | 指定が無く、想定外の言語の利用者が日本語版に着く |
| URL の表記をそろえる | 並べる URL は、各ページの canonical と同じ表記(プロトコルや末尾のスラッシュまで)にする(著者の点検規則) | http と https、末尾のスラッシュの有無が混ざる |
次は、温泉旅館の家族プランのページに書く指定の例です。
<!-- 日本語版 https://yamanoyu.example.jp/plan/family/ の head -->
<link rel="canonical" href="https://yamanoyu.example.jp/plan/family/">
<link rel="alternate" hreflang="ja" href="https://yamanoyu.example.jp/plan/family/">
<link rel="alternate" hreflang="en" href="https://yamanoyu.example.jp/en/plan/family/">
<link rel="alternate" hreflang="zh-Hant" href="https://yamanoyu.example.jp/zh-hant/plan/family/">
<link rel="alternate" hreflang="x-default" href="https://yamanoyu.example.jp/language/">
英語版と繁体字版にも同じ 4 行の alternate を並べ、canonical だけをそれぞれ自分の URL にします。ページ数が多いサイトでは、この指定を HTML ではなくサイトマップにまとめて書くこともできます。
タグが正しくても、中身が翻訳されていなければ意味がありません。Google は、本文が翻訳されていない場合に限って言語版を重複とみなす、と書いています。見出しとメニューだけを訳して本文が日本語のままのページは、ここに当たります。自動翻訳を使うなら、その言語を読める人が確かめてから公開します。点検では、各言語版の見出しの数・画像・構造化データ・title と description の翻訳がそろっているかを並べます。日本語版だけが更新され、他の言語版が古いままのページもここで拾います。
5 点の点検を手順書にすると、次のようになります。
---
name: hreflang-check
description: >-
  多言語・多地域のページの対応関係を検証し、壊れを見つけて直す。
  「多言語の SEO」「hreflang」「英語版が出てこない」で使う。
---
# 多言語ページの点検

## 壊れやすい 5 点
1. 相互に指し合っていない(英→日 だけあって 日→英 が無い)
2. 自分自身への指定が抜けている
3. 言語と地域のコードが間違っている(国コードを言語コードに使っている)
4. 正規 URL と食い違っている
5. 既定の言語の指定が無い

## 手順
対応表を作り、上の 5 点を順に確かめ、直したコードを生成する。
言語の切り替えが自動転送で行われているなら、それも一緒に報告する。
点検を 5 点に固定したのは、壊れ方が決まっているからです。片方だけの指定は両方とも無視され、jp や UK は正しいコードではなく、canonical と表記が違えば別のページを指したことになります。どの案件でも同じ 5 点なので、依頼文ではなく手順書に置きました。相互に指し合っているかは、1 ページずつ見ても分かりません。手順で対応表を先に作らせるのはそのためです。日本語版だけ更新して英語版が古いまま、という壊れ方は、全言語版を並べたときにしか見えません。直したコードまで生成させるのは、直しが 1 ページで済まないからです。英語版と繁体字版にも同じ alternate を並べ、canonical だけを変える必要があります。description の「英語版が出てこない」は、hreflang という語を知らない宿や飲食店の人の言い方です。見出しの数や title の翻訳がそろっているかの点検はこの骨子に入れていないので、本文の規則を書き足します。翻訳の中身が正しいかは、その言語を読める人が確かめる工程で、手順書では代わりになりません。
画像は「どれを遅らせないか」を先に決める
画像の点検でいちばん効くのは、読み込みの順番です。
- ファーストビュー(スクロールせずに見える範囲)の画像、特に LCP の対象になるメインの画像は、遅延読み込みにしない。遅延読み込みにすると LCP が遅れる(web.dev の解説)
- それより下の画像は
loading="lazy"で遅らせる - すべての画像に幅と高さ(または縦横比)を指定し、読み込み後にレイアウトがずれる CLS を防ぐ
- alt(画像の代替テキスト)は、写っているものを説明する文にする。ファイル名や語の羅列にしない
誤った報告が出やすい箇所は 2 つあります。1 つは、プラグインなどが JavaScript で遅延読み込みをしているサイトです。この場合は loading 属性が無いのが正常なので、「遅延読み込みをしていない」とは報告しません。どの方式で遅らせているかを所見に書きます。もう 1 つは画像の変換です。WebP などへの変換やリサイズの道具が無い環境では、どのファイルをどの形式・幅・品質に変えるかの指示書までを出します。変換していないのに「変換した」とは書きません。
画像の点検の手順書です。既存の画像を点検して直す担当で、無い画像を作る仕事は持ちません。
---
name: image-optimize
description: >-
  既存画像の代替テキスト・形式・対応サイズ・遅延読み込み・ズレ防止を点検して直す。
  「画像を最適化して」「alt を付けて」「画像が重い」で使う。
  ※画像の新規生成は画像生成のスキル(第 4 章)。
---
# 画像の最適化

## 手順
1. **どれを遅らせないか**を先に決める(最初に見える 1〜2 枚)
2. 残りを遅延読み込みにする
3. 幅と高さを指定し、読み込み中にレイアウトがずれないようにする
4. 代替テキストは**写っているものを説明する**(キーワードを詰めない)
5. 装飾の画像は代替テキストを空にする

## 出力
1 行 1 画像の表(URL・サイズ・形式・代替テキストの現状と案・遅延の可否)
手順の 1 を「どれを遅らせないか」から始めたのは、画像の点検でいちばん効くのが読み込みの順番だからです。「画像を遅延読み込みにする」を先に置くと、ファーストビューのメイン画像まで遅延の対象になり、LCP が遅れます。例外を先に決めてから残りを遅らせる順にしておけば、依頼文に LCP の話が無くても主役の画像は守られます。代替テキストには、キーワードの羅列やファイル名が入りがちです。手順の 4 で「写っているものを説明する」に限定しているのはそのためです。出力を 1 行 1 画像の表にし、現状と案を並べさせるのは、変換やリサイズの道具が無い環境があるからです。道具が無ければ指示書までを出し、変換していないのに「変換した」とは書かせません。遅延の欄も、方式を書く場所です。JavaScript で遅らせているサイトでは loading 属性が無いのが正常なので、「遅延していない」と断定させないためです。既存の画像を直す依頼と新しい画像を作る依頼はどちらも「画像」の語で来るので、境界を description に書いています。
店舗の構造化データ
店舗型ビジネスのサイトでは、構造化データを業種ごとの型(美容室なら HairSalon、宿泊施設なら Hotel など)で書くこと、自社の口コミの評点を載せても星は表示されないこと、分からない値を推測で埋めないことに注意します。書き方の例と注意点は、第 8 章の「構造化データ(LocalBusiness)」で詳しく扱います。
商品ページで足す点検
通販サイトの商品ページは、記事や店舗ページとは点検項目が違います。上の監査の入口が「商品ページが並んでいる」と見立てたときに、次の 4 つを足します。
- 商品の構造化データが、表示と合っているか。 価格・在庫の状態・通貨・返品条件・配送料は、ページに出ている値と一致させます。セールで価格を変えたときに構造化データだけが古い値のまま、が典型です。
- 在庫切れのページをどう扱うかを先に決める。 戻る見込みがあるなら残して代替を提示し、終売なら行き先を決めます。判断を決めずに放置すると、買えないページだけが検索結果に残ります。
- 同じ商品のページが何本あるかを数える。 色やサイズごとに URL が分かれる作りでは、同じ内容のページが数十本できます。どれを正規の URL にするかを決め、残りはそこへ寄せます。
- モールとの差を説明できるか。 大手モールに同じ商品がある場合、自社サイトが上に来る理由(正規店の情報量・使い方・サポート)をページ内に持たせます。
商品の構造化データを JavaScript で後から差し込む作りにしないことは、上の「重要な指定は最初の HTML で返す」の節で触れました。価格の比較をレポートに載せるときは、取得日と取得元の URL を必ず添えます。 価格は日単位で変わるので、日付の無い価格表は翌日には嘘になります。
この 4 つを、監査の入口から委譲される手順書にしておきます。
---
name: product-page-seo
description: >-
  通販サイトの商品ページを点検する(商品の構造化データ・在庫切れ・URL の分裂・
  モールとの差)。
  「EC の SEO」「商品ページを見て」「ショッピングに出てこない」で使う。
---
# 商品ページの点検

## 手順
1. 価格・在庫・通貨・返品条件が、表示と構造化データで一致しているか
2. 在庫切れのページの扱いが決まっているか(戻る見込みがあるかで分ける)
3. 同じ商品のページが何本あるかを数え、正規の URL を決める
4. モールに同じ商品がある場合、自社が上に来る理由をページ内に持たせる

## 守ること
- 価格の比較を載せるなら、取得日と取得元の URL を必ず添える
- 商品の構造化データを描画後に差し込む作りにしない
この手順書は、常に呼ぶ担当ではなく「商品ページのシグナルがあるとき」に入口から委譲される形にしました。点検項目が記事や店舗ページと違うからです。常に呼べば、商品を売っていないサイトに在庫切れやモールの所見が付きます。セールで価格を変えたときに構造化データだけが古い値のまま、というのが典型的な壊れ方なので、手順の 1 で価格・在庫・通貨・返品条件を表示と突き合わせさせます。手順の 2 で在庫切れの扱いを先に決めさせるのは、決めずに放置すると買えないページだけが検索結果に残るからです。守ることの 1 つ目は、価格の比較に取得日と取得元の URL を必ず添えること。価格は日単位で変わり、日付の無い価格表は翌日には嘘になります。2 つ目の「描画後に差し込まない」は、前の「重要な指定は最初の HTML で返す」の節で述べた、商品の構造化データを動的に生成するとショッピング向けのクロールが少なく不安定になりうる、という Google の説明にもとづきます。
コンテンツの質を点検する——E-E-A-T と検索意図
記事を作る前に、「良いページ」を点検できる項目に分けておきます。ここを決めずに執筆を自動化すると、AI は上位ページの平均をなぞった記事を量産し、どこが足りないのかを誰も指摘できません。点検の軸は 2 つです。ページの書き手と中身を見る E-E-A-T と、ページの形が検索結果と合っているかを見る検索意図の確認です。
E-E-A-T を点検項目に分ける
E-E-A-T は、Google が検索品質評価ガイドラインで使っている観点で、経験(Experience)・専門性(Expertise)・権威性(Authoritativeness)・信頼性(Trustworthiness)の頭文字です。2022 年 12 月に「経験」が加わり、それまでの E-A-T から今の形になりました。Google の有用なコンテンツの作成に関するドキュメントは、次の 3 点をはっきり書いています。
- 4 つのうち最も重要なのは信頼性で、残りの 3 つは信頼性を支える要素である
- E-E-A-T そのものはランキング要因ではない。システムは E-E-A-T を示すページを見分けるために、複数のシグナルを組み合わせて使う
- 健康・お金・安全・社会に大きく影響するトピック(YMYL: Your Money or Your Life)では、この観点をより重く扱う
「ランキング要因ではない」を「気にしなくてよい」と読まないようにしましょう。E-E-A-T は、Google が良いページとみなす状態を、人が読める言葉で書いたものです。点数を直接上げる設定項目は無いので、ページの上で確かめられる事実に置き換えて点検します。
| 要素 | ページで確かめること | AI に書かせるときの作り方 |
|---|---|---|
| 経験 | 自分で撮った写真・自社の数字・実際にやった手順・失敗の記録があるか | 取材で一次情報を集め、それを主役にした見出しを置く。取材に無い体験は書かせない |
| 専門性 | 著者名と経歴・資格が見えるか。主張に出典が付いているか。用語が正しいか | 著者プロフィールを正本として渡し、本文の著者表記はそこからだけ作る |
| 権威性 | 第三者のサイト・媒体・口コミで、この会社や著者が言及されているか | ページの中では作れない。取材記事・事例掲載・登壇など、外での言及を増やす施策として別に管理する |
| 信頼性 | 運営者・所在地・連絡先・プライバシーポリシー・更新日・訂正の記録があるか。広告と本文の区別が明確か | サイト共通の部品として 1 箇所で持ち、記事ごとに書かせない |
表の右の列を見ると、AI が本文を書いて埋められるのは経験と専門性の一部だけだと分かります。権威性と信頼性はサイトの外や運営の側にあり、記事の書き方では変わりません。この区別を点検結果にも書いておくと、「記事を直しても効かない所見」をライターに渡してしまう取り違えを防げます。
Google はもう 1 つ、Who / How / Why の 3 つの問いで自己点検するよう勧めています。
| 問い | 見るもの | 弱いときの例 |
|---|---|---|
| Who(誰が作ったか) | 著者名・経歴ページ。読者が気にする場面で見えるか | 「編集部」だけで、誰が確認したのか分からない医療・金融の記事 |
| How(どう作ったか) | 調べ方・検証の方法・AI や自動化を使った範囲の説明 | 「おすすめ 10 選」なのに、何を基準に選んだかが書かれていない |
| Why(なぜ作ったか) | 読者の役に立つために作ったか、検索流入を集めるためだけに作ったか | 専門外の分野に、流入が多いという理由だけで記事を増やしている |
AI で書いた文章であること自体は問題になりません。Google は、作り方ではなく中身の価値で評価すると説明しています。問題になるのは、価値の無いページを大量に作ることです。これはスパムポリシーの「大量生成されたコンテンツの不正使用(scaled content abuse)」にあたります。
点検を毎回同じ基準で行うために、評価の担当を 1 つのスキルにまとめます。次は骨子の例です。
---
name: page-quality-review
description: >-
  記事や LP の品質を E-E-A-T と Who/How/Why の観点で点検し、要素ごとの所見と
  直し方を返す担当。サイト全体監査からの委譲、または「この記事の品質を見て」
  「E-E-A-T の観点でレビューして」で使う。
  ※検索順位や流入の分析は流入分析のスキル、文体だけの修正は文体リライトのスキルへ。
---
# ページ品質の点検

## 手順
1. ページを描画して、本文・見出し・著者表記・日付・構造化データを取得する
2. 要素ごとに、ページ上で確かめられた事実だけを所見として書く
   - 経験: 自社の写真・数字・手順・失敗の記録(ストック写真は数えない)
   - 専門性: 著者名、経歴ページへのリンク、主張ごとの出典
   - 権威性: ページ内では判定しない。外部での言及は「別途調査」と書く
   - 信頼性: 運営者情報・連絡先・ポリシー・公開日と更新日・広告表記
3. Who / How / Why のそれぞれに「答えがある / 弱い / 無い」を付ける
4. YMYL に当たるトピックかを判定し、当たる場合は著者と監修者の表記を必須項目にする

## 出力
- 一言でいうと(3 行)
- 要素ごとの所見(根拠の引用つき)と、直す担当(ライター / サイト運営 / 広報)
- 取得できなかった項目は「未取得」と書き、推測で埋めない

## しないこと
- 点数だけを出さない。点数は重みを 1 箇所に固定したときだけ出し、根拠の所見を必ず並べる
- 「権威性を上げる文章」を本文に書き足す提案をしない(本文では変わらない)
評価の担当を 1 つの手順書にまとめ、description でサイト全体監査からの委譲と「この記事の品質を見て」の両方から呼べるようにしているのは、点検の基準を 1 箇所に持つためです。監査から呼んだときと記事 1 本を頼んだときで基準が違うと、同じページに 2 通りの評価が付きます。
手順の 2 で「ページ上で確かめられた事実だけ」を所見にさせているのは、E-E-A-T がランキング要因ではなく、点数を直接上げる設定項目が無いからです。事実に置き換えないと、所見は「専門性が弱い」のような印象の文になり、誰も直せません。権威性と信頼性はサイトの外や運営の側にあり、記事の書き方では変わりません。だから権威性は「ページ内では判定しない」とし、出力では直す担当をライター・サイト運営・広報に分けさせています。この区別が無いと、記事を直しても効かない所見がライターに渡ります。YMYL のときは、手順の 4 で著者と監修者の表記を必須にしました。Google がそのトピックでこの観点をより重く扱うと書いているからです。
しないことの 1 つ目、点数だけを出さないのは、重みを 1 箇所に固定していない点数は実行ごとに変わり、根拠の所見が無ければ何を直せばよいか分からないからです。2 つ目は、権威性の不足を指摘された AI が「業界随一の」「多くの専門家が認める」といった根拠の無い形容を本文に足す動きを止めるために入れています。権威性は本文では変わらないので、この提案は所見を消すだけです。
E-T-R: E-E-A-T を AI が確かめられる形に言い換える
E-E-A-T は人の評価者が読むための観点で、「経験」「権威性」のように、ページの文字からは機械的に判定しにくい要素を含みます。そこで国内の AIO 対策の支援会社が、E-E-A-T を AI 向けに言い換えた E-T-R という整理を提案しています(ETR とも書かれます)。AI は「誰が言ったか」より「その情報の根拠は何か」「検証できるか」を重く見る、という考えにもとづいた整理です。
| 要素 | 提唱元の説明 | この章で対応する点検 |
|---|---|---|
| E: Evidence(根拠) | 「人気です」のような主観的な主張ではなく、数値データを示す | GEO の対策の「出典・数値・引用を入れる」。GEO の論文では、統計・数値を加える書き方が効果の大きい手法に入った |
| T: Traceability(追跡性) | 出典の URL・監修者・更新日を明記し、AI が情報の経路をたどれるようにする | E-E-A-T の専門性と信頼性、Who / How の問い。GEO の論文の「出典を示す」 |
| R: Retention(定着性) | 1 段落 200〜400 字の独立した「意味のまとまり」を作り、AI が繰り返し利用しやすい形にする | GEO の対策の「段落の冒頭で答える」と、コサイン類似度による段落単位の確認 |
提唱元は、この 3 つを「根拠を示す → 出典を書く → 構造を整える」の順に積み上げる形(ラダー構造)で使うよう勧めています。表の「この章で対応する点検」の中身は、この節の後の LLMO の節で説明します。
E-T-R を使うときの注意は 3 つです。
- 提唱元の独自の整理で、Google や AI 各社が使っている用語ではありません。記事の中には、E-T-R を満たすと引用が増えることを示す外部の検証(論文や公式文書)は示されていません。表の右の列のとおり、3 つの要素はそれぞれ Google の文書や GEO の論文と同じ方向を指しているので、点検の観点として使うのは有効です。ただし「E-T-R を満たせば AI に引用される」とは言えません
- E と T は組で点検します。「満足度 96%」と書いても、調査の時期・方法・回答数が書かれていなければ、AI にも読者にも確かめようがありません。根拠の数値には、必ず出どころを添えます
- R の「200〜400 字」は目安として扱います。Google は、AI のために文章を小さく分割する必要は無いと書いています。字数で機械的に段落を切るのではなく、「1 つの段落が 1 つの問いに答え、その段落だけ読んでも意味が通るか」を確かめます
E-E-A-T の点検と組み合わせるなら、前の点検スキルの手順に 1 項目足すのが簡単です。
5. AI 向けの補助点検(E-T-R)として、主要な主張ごとに次の 3 つを確かめる
   - 根拠: 主張に数値・事実が付いているか(「人気」「好評」だけで終わっていないか)
   - 追跡性: その数値に出どころ(調査の時期・方法・母数、または出典 URL)があるか。
     ページに著者・監修者・更新日が見えるか
   - 定着性: 主張を含む段落が、前後を読まなくても意味が通るか。段落の冒頭で答えているか
   E-E-A-T の所見とは別の表に分けて出す(E-T-R は Google の用語ではないため)
別の表に分けるのは、点検結果を読んだ人が、E-T-R の所見を Google の基準と取り違えないようにするためです。
ページの形を検索結果に合わせる
E-E-A-T を満たしても上位に出ないページがあります。原因として多いのは、ページの種類が検索意図と合っていないことです。あるキーワードの上位 10 件のうち 8 件が商品一覧のページなら、どれだけ丁寧な解説記事を書いても、その検索結果には入れません。この点検を SXO(Search Experience Optimization: 検索体験の最適化)と呼ぶことがあります。
手順は、検索結果を先に読み、ページを後から合わせる順です。
- 対象のキーワードで実際に検索し、広告と AI による概要を除いた上位 10 件を取る
- 各ページを種類で分類する(下の表)
- 最も多い種類の割合を数える。6 割を超えれば検索意図は定まっている、4〜6 割なら混在、4 割未満なら定まっていない
- 自社のページの種類と比べる。違っていれば、直す対象はページの中身ではなく種類になる
日本語の検索結果では、次の 11 種類で分けると判定がぶれにくくなります。
| 種類 | 判定の目安 |
|---|---|
| 知識 | 「とは」「仕組み」「方法」など、情報を説明する記事 |
| 解決 | 「〜できない」「どうやって」など、特定の問題を解く記事 |
| 権威 | 行政・大学・研究機関・公的団体のページ(ドメインで判定できる) |
| まとめ | 「〇選」「一覧」など、複数の情報を集めた記事 |
| 鮮度 | 「最新」「速報」「2026 年」など、時事性を前に出す記事 |
| 比較 | 「比較」「違い」「どっち」など、複数の対象を比べる記事 |
| おすすめ | 「おすすめ」「選び方」など、順位を付けずに推薦する記事 |
| ランキング | 「ランキング」「TOP10」など、順位付きの記事 |
| モール | EC モールの商品一覧・カテゴリページ |
| SNS | SNS の投稿・アカウント・動画のページ |
| その他 | 商品詳細・サービスのトップなど、上のどれにも入らないもの |
モール・SNS・権威が上位の大半を占めるキーワードでは、中小のサイトが入れる順位がほとんど残っていません。この判定を後の節のキーワード選定と合わせて行えば、書いても上がらない記事に工数を使う前に止められます。
ここまでの判定を 1 つの担当に任せるなら、次のような骨子になります。
---
name: serp-page-type
description: >-
  キーワードの上位ページを種類で分類し、どの形式を作れば入れるかを判定する。
  「どんな記事を作ればいい」「コンテンツの種別を判定して」で使う。
  ※「よく最適化されているのに上がらない」の原因調べは検索体験のスキル。
---
# 上位ページの種類判定

## 手順
1. 上位 10 件を種類で数える(知識 / 解決 / 権威 / まとめ / 鮮度 / 比較 /
   おすすめ / ランキング / モール / SNS / その他)
2. 過半を占める種類を、作るべき形式とする
3. 自社が作れない種類(モールなど)が過半なら、**その語を追わない**と書く

## 出力
種類の内訳表と、作る形式の結論 1 行(取得日を添える)
この手順書を種類の判定だけに切ったのは、書く前に使う判定だからです。キーワード選定と合わせて行い、モールや SNS が過半の語なら書く前に止めます。まだページが無い段階で読み手の採点まで持たせても、採点する対象がありません。11 種類と「過半」の基準は手順書に固定しました。日本語の検索結果ではこの分け方が判定をぶれにくくするうえ、実行ごとに分け方が変わると、同じ語の結論が月によって変わるからです。手順の 3 で「その語を追わない」と書かせるのは、中小のサイトが入れる順位が残っていない語に、記事の工数を使う前に止めるため。出力に取得日を添えさせるのは、判定の根拠がその日に Google が返した並びだからで、日付が無いと、結論が変わったときに検索結果が動いたのか分類が変わったのか分かりません。「よく最適化されているのに上がらない」は検索体験のスキルへ送っています。既にあるページの診断で、入力も使う時期も違うからです。
検索結果からは、ページの種類のほかに、読み手が何につまずいているかも読み取れます。「他の人はこちらも質問」の質問は知識の不足を、広告文の訴求は購入の決め手を、関連する検索は前後の行動を示します。これらを材料に想定読者を 4〜7 人分に分け、それぞれについて「求めている情報があるか・10 秒以内に見つかるか・信用できる材料があるか・次の行動が分かるか」の 4 点でページを採点すると、どの読み手向けの情報が欠けているかが分かります。
読み手ごとの採点までを受け持つ担当は、種類の判定とは分けて持ちます。
---
name: search-experience-check
description: >-
  上位に並んでいるページの形と自社ページの形が合っているかを見、
  複数の読み手の目線で採点する。
  「よく書けているのに上がらない」「意図が合っていない」で使う。
---
# 検索体験の点検

## 手順
1. 検索結果を先に読み、上位のページの形を書き出す
2. 自社ページの形と照らし、食い違っている点を並べる
3. 読み手を 3 人想定し(初めての人 / 比較中の人 / 決めたい人)、
   それぞれが欲しい情報がどこにあるかを採点する
4. 形が合っていなければ、本文を足すのではなく**ページの種類を変える**提案をする

## 出力
上位の形の表 → 食い違い → 読み手別の採点 → 結論(直す / 別のページを作る / 追わない)
読み手ごとの採点を種類の判定と分けたのは、入力が違うからです。種類の判定はキーワードだけで動き、書く前に使います。こちらは既にあるページが前提で、description の「よく書けているのに上がらない」は、E-E-A-T を満たしても上位に出ないページを持つ人の言い方です。ページを先に読むと、そのページの出来を評価して本文を足す提案になります。だから手順の 1 では検索結果を先に読ませます。上位 10 件のうち 8 件が商品一覧なら、丁寧な解説記事をどれだけ直しても入れません。順番を固定しておけば、手順の 4 の「本文を足すのではなくページの種類を変える」提案につながります。手順の 3 の読み手を 3 人に固定しているのは骨子としての最小で、本文で述べた「他の人はこちらも質問」や広告文から起こす 4〜7 人の読み手は、材料が揃った回に依頼文で足します。結論は「直す / 別のページを作る / 追わない」の 3 つに閉じました。「追わない」を選択肢に持たないと、入れない語でも直す提案が返ります。
上位ページとは、平均ではなく分布で比べる
自社のページを上位ページと比べるとき、「上位 10 件の平均文字数は 8,200 字です」という報告を見ることがあります。この数字は、ほとんどの場合役に立ちません。上位 10 件に 3 万字の網羅記事が 1 本混ざるだけで、平均は残り 9 件のどれとも似ていない値になるからです。目標値にすれば、水増しを指示しているのと同じことになります。
比べるなら分布で見ます。上位ページを項目ごとに並べ、下から 1/4 の値と上から 1/4 の値を出して、その間に入っているかを見る。入っていれば、その項目は問題ではありません。外れている項目だけが改善の候補です。
| 項目 | 上位の範囲(下 1/4〜上 1/4) | 自社 | 判定 |
|---|---|---|---|
| 本文の文字数 | 3,200〜7,800 | 3,900 | 範囲内。増やさない |
| 見出し(h2)の数 | 5〜11 | 3 | 下に外れている。論点の抜けを疑う |
| ページ内のリンク数 | 8〜24 | 2 | 下に外れている。関連ページへの導線が無い |
| 画像の枚数 | 4〜14 | 19 | 上に外れている。表示速度を確かめる |
| 構造化データの有無 | 10 件中 9 件があり | 無し | 外れている。追加の候補 |
この表の価値は、「直さなくてよい項目」が分かることです。改善の提案は放っておくと長くなりますが、手を動かせる人の時間は有限です。範囲に入っている項目を「問題なし」と書いて潰しておくと、残った数項目に集中できます。
注意が 2 つあります。件数が少なければ範囲を出さないこと。上位 5 件しか取れていない状態で四分位を出しても、値が安定しません。件数を必ず併記し、足りなければ「参考値」と書きます。もう 1 つは、範囲に合わせることが目的ではないこと。これは相関を見ているだけで、上位にあるからその値になったのか、その値だから上位にあるのかは分かりません。レポートには「上位の分布から外れている項目」と書き、「これを直せば上がる」とは書きません。
分布で比べる手順を手順書にすると、次のようになります。この手順書が受け持つのは、自社ページを上位の分布と並べて外れている項目を挙げるところまでで、直し方は出しません。
---
name: top-page-benchmark
description: >-
  自社ページを上位ページの**分布**と比べ、外れている項目だけを改善候補にする。
  「上位ページと比べて」「どこを直せばいい」「SEO 診断して」で使う。
  ※単一ページの全項目診断はページ診断のスキル。
---
# 上位ページとの比較

## 手順
1. 上位ページを項目ごとに並べる(文字数・見出し数・内部リンク・画像・構造化データなど)
2. 項目ごとに下から 1/4 と上から 1/4 の値を出し、**範囲に入っているか**を見る
3. 入っている項目は「問題なし」と書いて潰す
4. 外れている項目だけを、上に外れ / 下に外れで分けて並べる

## 守ること
- 件数を必ず併記し、少なければ「参考値」と書く
- 「これを直せば上がる」と書かない(見ているのは相関だけ)
- 平均値を目標にしない(水増しを指示することになる)
この手順書を「外れている項目を挙げるだけ」に切っているのは、比較で分かるのが相関だけだからです。全項目を点検して欠陥を挙げるページ診断と 1 つにすると、観察と欠陥が同じ表に並び、読んだ人はどちらも直すべき問題として受け取ります。description の末尾でページ診断を別のスキルへ送っているのはそのためです。
手順 2 を四分位にし、平均を目標にしないことを守ることに入れた理由は、節の冒頭で見たとおりです。3 万字の網羅記事が 1 本混ざるだけで平均は残り 9 件のどれとも似ない値になり、それを目標にすれば水増しの指示になります。この比較の価値は「直さなくてよい項目」が分かることにあります。手順 3 で範囲内の項目を「問題なし」と書いて潰させるのはそのためで、潰さないと提案は長くなる一方で、手を動かせる人が残った数項目に集中できません。件数の併記は、上位 5 件で四分位を出しても値が安定しないためです。「これを直せば上がる」と書かない規則は、上位にあるからその値なのか、その値だから上位なのかを、この比較では区別できないと毎回の報告に残すためのものです。
キーワードは検索結果の重なりでまとめる
1 記事で書くか、親ページと子記事に分けるかを決めるときは、キーワード同士の文字が似ているかではなく、検索結果の重なりで判断します。2 つのキーワードで検索し、上位 10 件に共通して出る URL を数えます。
| 共通する URL | 関係 | 扱い |
|---|---|---|
| 7〜10 件 | 同じ検索意図 | 1 ページにまとめる。分けると自社のページ同士で順位を奪い合う(カニバリゼーション) |
| 4〜6 件 | 同じまとまり | 同じ親ページの下の子記事にする |
| 2〜3 件 | 隣り合うまとまり | 別のまとまりに置き、相互にリンクする |
| 0〜1 件 | 関係なし | 別のまとまりにするか、対象から外す |
文字が似ていても検索結果が違えば、検索エンジンは別の意図として扱っています。たとえば「子連れ 温泉旅館」と「赤ちゃん 温泉旅館」は、上位のページが大きく違うことがあります。この判定は Google が実際に返した結果にもとづくので、推測が入りません。
注意点は比較の回数です。40 語の総当たりは 780 組になります。先に検索意図(知りたい・比べたい・買いたい)で 4 つ程度のグループに分け、グループの中と境界の語だけを比べれば、200 組前後に減らせます。まとめ方が決まったら、子記事から親ページへ・親ページから全子記事へのリンクを必須にし、どの記事も親ページから 2 クリック以内で届くようにします。どこからもリンクされていないページ(孤立ページ)が 0 件であることを、公開前に機械で確かめます。
この章の後半の LLMO の節では、文章の意味の近さを数値にする「コサイン類似度」が出てきます。キーワードをまとめる場面で文章の類似度を使わないのは、検索エンジンの判断そのもの(検索結果)を直接観測できるからです。AI 検索では、回答に使う段落の選ばれ方を外から観測する手段が限られるので、類似度で近似します。
重なりでまとめる手順の骨子です。この手順書が出すのは親子の設計と内部リンクの表までで、ページの本文は書きません。
---
name: topic-cluster
description: >-
  キーワードを、文字が似ているかではなく**上位ページの重なり**でまとめ、
  親ページと子ページの設計と内部リンク表を作る。
  「トピッククラスタ」「ピラーページ」「キーワードをグループ化して」で使う。
---
# トピックのまとめ方

## 手順
1. 軸の語から候補を広げる
2. 2 語ずつ上位ページを比べ、**重なった件数**で同じページにするかを決める
3. 群ごとに親 1 枚と子 3〜8 枚を割り当てる
4. 内部リンクの表を作る(どのページからどのページへ、どの文言で)

## 守ること
- 重なりのしきい値を先に決め、途中で変えない
- 同じ意図の語でページを 2 枚作らない(自社で競合する)
description で「文字が似ているかではなく上位ページの重なり」を強調しているのは、この作業でいちばん多い取り違えが、語の見た目でまとめることだからです。「子連れ 温泉旅館」と「赤ちゃん 温泉旅館」のように、文字が似ていても上位が大きく違う語を 1 ページに押し込むことになります。手順 2 で判定の材料を重なった件数だけにしているのは、Google が実際に返した結果にもとづくので推測が入らないためで、文章の類似度をここで使わないのも同じ理由です。
しきい値を先に決め、途中で変えないことは守ることに置きました。この判定で推測が入りうる場所は、そこだけだからです。組ごとにしきい値が動けば、結果は検索結果ではなく作業する側の都合を映します。同じ意図の語でページを 2 枚作らない規則は、自社のページ同士で順位を奪い合う失敗を、依頼する人が毎回書かなくても止めるためです。手順 4 の内部リンクの表には文言まで含めました。親から 2 クリック以内・孤立ページ 0 件という条件を、公開前に機械で確かめられる形にするためです。
構造化データは「見えている内容と同じこと」を書く
構造化データ(JSON-LD で書く schema.org の語彙を使った記述)は、会社名・商品・価格・著者などを機械が読める形で渡す手段です。書くときの規則は 2 つです。
- ページに表示されている内容と同じことだけを書く。Google は AI 機能についても、構造化データが見えている本文と一致していることを求めています
- リッチリザルト(検索結果の装飾表示)が終わった型を、表示目的で新しく足さない。HowTo は 2023 年に、FAQ は 2026 年 5 月に Google 検索での表示が終わりました。既存の記述を急いで消す必要はありませんが、「入れると検索結果で目立つ」という理由で提案するのは誤りです
会社(Organization)・著者(Person)・商品(Product)・記事(Article)の記述は、装飾表示が無くても、「このページが何について書かれ、誰が責任を持つか」を機械に伝える手段として残ります。E-E-A-T の信頼性と、後で述べる LLMO のエンティティの整理の両方に使います。
構造化データの検出から生成までを受け持つ担当の骨子です。生成までは行いますが、公開はしません。
---
name: schema-markup
description: >-
  ページの内容を検索エンジンが読める形で書き添える(構造化データ)。検出・検証・生成を行う。
  「構造化データ」「JSON-LD」「リッチリザルト」「マークアップを付けて」で使う。
---
# 構造化データ

## 手順
1. ページの種類に合う**いちばん具体的な型**を選ぶ(汎用の型のままにしない)
2. 必須項目を埋め、推奨項目は分かるものだけ埋める
3. **ページに表示されている内容と一致させる**(表示に無い値を書かない)
4. 分からない値は推測で埋めず、「要確認」の印を残して人が埋めてから公開する

## やらないこと
- 自分で管理している口コミの評点を自社ページに書かない
- 1 つのデータに複数拠点を並べない(拠点ごとに 1 つ、識別子を分ける)
検出・検証・生成を 1 つの担当にまとめているのは、3 つが同じ規則で動くからです。書いてよいのは、ページに表示されている内容と同じことだけ。担当を分けると、生成の側が表示に無い値を足しても、検証の側にそれを見つける基準がありません。手順 3 で一致を強調しているのは、Google が AI 機能についても一致を求めていることに加えて、この記述を E-E-A-T の信頼性と LLMO のエンティティの整理に使うからです。本文と食い違う記述は、同じ会社の情報として集まりません。
手順 4 で分からない値を「要確認」の印にし、人が埋めるまで公開させないのは、「取れなかった数字を埋めない」を記述の側に当てたものです。推測で埋めた値は、表示と食い違っていても機械には正しく見えます。やらないことに口コミの評点を入れたのは、載せても星が表示されず、表示目的の提案にしかならないからです。1 つのデータに全拠点を並べると、どの住所がどのページの店か機械に読めません。拠点ごとに 1 つに分けるのはそのためです(第 8 章)。description に「リッチリザルト」の語を残したのは、依頼する人の多くがその語で頼むからです。装飾表示が終わった型を足す提案を、その語で呼ばれた回にも止めるためでもあります。
記事を作る——正本から生成し、下書きで止める
姉妹記事の「インバウンド」の図で、記事は都度書くものではなく、構造化された正本(事例・機能・業界データ)から生成するものだと述べました。ここではその生成を工程に分解します。要点は 2 つだけです。一次情報を入れる工程を省かないこと。公開の判断を人に残すこと。
正本に入れるのは、ネットで調べれば分かる情報ではなく、社内にしか無いものです。実際の案件の事例と数字、現場で積み上げた手順と失敗の記録、顧客から繰り返し受ける質問とその答え、といった社内のノウハウと実績です。AI が検索して答える時代には、Web にすでにある情報を集めて書き直したページは選ばれる理由がありません。同じ作業を AI 自身が回答を作る過程で行っているからです。この章では上位ページを調べる工程が何度も出てきますが、それは「何を書けば足りるか」の下限と、自社に無い話題を知るためです。書く材料はそこからは取らず、社内から取ります。Web の調査は裏づけと比較にだけ使います。この順番は、通常の検索に向けた SEO でも、AI の回答に向けた LLMO でも同じです。

図は横にスクロールできます。図を原寸で開く
図の元になった mermaid を見る
flowchart LR
  SRC[("構造化された正本<br/>事例 / 機能 / 業界データ")] --> KW["キーワードを決める<br/>難易度は上位 10 件の顔ぶれ<br/>実数はキーワードプランナー"]
  KW --> OUTL["構成案<br/>上位 10 件の見出し分析<br/>必須トピック → 独自要素"]
  OUTL --> WRITE["執筆<br/>AI 取材で一次情報を入れる<br/>対話できない実行は【要取材】を残す"]
  WRITE --> HUM["人間らしく<br/>事実・数値・構成は変えない"]
  HUM --> REV["競合比較レビュー<br/>公開ブロッカー / 推奨 / 任意"]
  REV -->|"大幅な書き直し"| WRITE
  REV --> DRAFT["CMS へ下書き入稿(承認)"]
  DRAFT --> PUB["公開は人が CMS で行う"]
  PUB --> IDX["インデックス送信(承認)"]
  IDX --> MEAS["2〜4 週間後に順位と流入を再計測"]
  MEAS -.成果が出たら.-> SRC
キーワードを決める
難易度は、実際の検索結果の上位 10 件に誰がいるかで判断します。大手企業・行政・大手メディアが独占していれば今は狙わず、専門ブログや中小企業のサイトが上位にいるなら狙い目です。ページの中身より運営者の種別のほうが効く、というのが実感です。判断材料はレポートに必ず書きます。
検索回数は推測で数字にしません。実数の一次ソースはキーワードプランナーだけで、取れないときは「多い・ふつう・少ない」の相対評価にとどめ、推定と明記します。もっともらしい数字は、誰も疑わないまま予算配分の根拠にされてしまいます。実数にも注意点があります。広告費ゼロのアカウントでは丸めた範囲で返るので「概算」と書く。表記ゆれを統合した合算値を、単独の語の数字として扱わない。入札単価(通貨単位の 100 万分の 1 で返る)の換算を推測で書かない。もう 1 つ決めるのは、1 記事で足りるか、親ページと子記事のまとまりで攻めるかです。上位が単発の解説記事ばかりなら前者、カテゴリページや特集が多く関連語が枝分かれするなら後者を選びます。
キーワードの一覧は、難易度と実数を別の列に置く
キーワードの候補を並べるときは、性質の違う数字を 1 つの列にまとめません。難易度は上位 10 件の顔ぶれから判定した値、月間検索数はキーワードプランナーの実数、広告の競合性は広告枠の埋まり具合です。出どころも意味も違います。次は温泉旅館の例です(数字は説明用の架空の値です)。
| キーワード | 難易度(5 段階) | 月間検索数 | 検索が多い月 | 記事の形 | 狙い目 |
|---|---|---|---|---|---|
| 温泉旅館 子連れ | 3.5 | 2,400 | 7〜8 月 | 親ページ + 子記事 | ○ |
| 子連れ 温泉 離乳食 | 2.0 | 320 | 通年 | 1 記事 | ◎ |
| 露天風呂付き客室 家族 | 4.5 | 1,600 | 12〜1 月 | 1 記事 | × |
| 温泉旅館 ベビーベッド 貸出 | 1.5 | 未取得 | 未取得 | 1 記事 | 実数の取得後に判定 |
難易度は、上位の運営者の種類で 5 段階に付けます。大手企業・行政・大手メディアが占めていれば 5、個人のブログや Q&A サイトが入っていれば 1 です。どんな運営者が何件いたかという根拠は、表とは別に残します。狙い目は難易度と検索数の組み合わせで決めます。難易度が低く検索数が中程度以上なら ◎、難易度が高いものは今は狙わない × です。実数が取れなかった行は「未取得」のまま残し、狙い目も判定しません。検索数は地域と言語の指定で変わるので、表の上に「日本・日本語」のように取得条件を書きます。宿泊や観光のように繁忙期がある業種では、年平均だけでなく月別の推移を見ます。検索が増える月より前に記事が評価され始めるよう、公開の時期を逆算します。
キーワードの選定を手順書にしたものです。受け持つのは「勝てる語を選ぶ」判断だけで、検索回数の実数は取りません。
---
name: keyword-difficulty
description: >-
  キーワードの難易度・サジェスト・推奨する記事形式を調べ、勝てる語を選ぶ。
  「キーワード調査」「上位表示できるか調べて」「記事のキーワードを選定して」で使う。
  ※検索ボリュームと CPC の実数値はキーワード実数値のスキル(第 5 章)。
---
# キーワードの選定

## 手順
1. 軸になる語を 1 つ決め、サジェストと関連語を広げる
2. 上位に並んでいるページの**種類**を数える(公式 / 大手メディア / 個人 / モール)
3. 自社で勝てるかを、上位の種類と自社の一次情報の有無で判定する
4. 採用しない語にも理由を 1 行書く(来月同じ語を再検討しないため)

## やらないこと
- 難易度のスコアを自分で数値化して断定しない(根拠は上位の顔ぶれ)
実数の取得を description で第 5 章のスキルへ送り、この手順書に持たせないのは、難易度と検索数が出どころも意味も違う数字だからです。一覧で別の列に置くのと同じ理由で、担当も分けています。1 つの手順書に両方を出させると、実数が取れない回に「多そう」という推定が数字の顔をして同じ列に入り、誰も疑わないまま予算配分の根拠にされます。
手順 2 で上位の運営者の種類を数えさせるのは、ページの中身より運営者の種別のほうが効く、という著者の実感からです。やらないことには「スコアを自分で数値化して断定しない」を置きました。値だけが残ると、来月何を見て付けた値か分からなくなります。根拠は「どんな運営者が何件いたか」で残します。手順 4 では、採用しない語にも理由を書かせます。同じ語を翌月また調べ直す往復を止めるためです。
上位ページから構成を起こす
上位 10 件のタイトル・見出し・説明文・文字数を集め、見出しの話題を意味でまとめて「何割のページが触れているか」で仕分けます。8 割以上が扱う話題は必ず入れる、5〜7 割は入れたほうがよい、3〜4 割は余力があれば、の 3 段です。そのうえで、上位に無い自分だけの話(実体験・自社データ・現場の知見)を足します。共通点だけを揃えたページは「上位の平均」でしかなく、選ばれる理由がありません。見出しはそのまま写さないこと。10 件のつもりが 6 件しか取れなかったなら、6 件で分析したと正直に書きます。
構成案づくりを手順書にすると、次のようになります。
---
name: article-outline
description: >-
  指定キーワードの上位ページを読み、記事の見出し構成案と執筆指示書を作る。
  「記事構成案を作って」「見出しを考えて」「タイトル案がほしい」で使う。
  ※既存記事のリライト診断は記事監査のスキル。
---
# 記事の構成案

## 手順
1. 上位 10 件の見出しを抜き出し、何件中何件に出てくる論点かを数える
2. 過半に出てくる論点は入れる。少数の論点は「差別化の候補」に回す
3. **上位に無いが自社にある一次情報**を 1 つ以上入れる(無ければ取材を提案する)
4. 見出しごとに「ここで読者が分かること」を 1 行書く
5. タイトル案を 3 つ。本文で回収しない約束を入れない

## 出力
論点の出現回数の表 → 見出し構成 → タイトル 3 案 → 取材が要る箇所
この手順書は構成案と執筆指示書を出すところまでで、本文は書きません。description の末尾でリライト診断を別のスキルへ送っているのは、「見出しを考えて」が既存記事の依頼だったときにこの手順書が立つと、いまの流入を支えている語を守る工程の無いまま新しい構成が返るからです。
手順 1 で「何件中何件」まで数えさせるのは、10 件のつもりが 6 件しか取れなかったときに、6 件で分析したと正直に書かせるためです。共通点だけを揃えた構成は「上位の平均」でしかなく、選ばれる理由を持ちません。手順 3 で上位に無い一次情報を 1 つ以上入れさせるのはそのためです。この章の最初の表に挙げた「平均のページの量産」は構成の段階で決まるので、ここで止めます。無ければ取材を提案する、と縮退先まで書いてあるのは、一次情報が手元に無い回でも構成案をゼロにしないため。手順 5 の「本文で回収しない約束を入れない」は、レビューで「5 選」の回収を検査する規則と対で、レビューで見つかれば本文の書き直しになるので、約束を作る側で先に止めます。
外部の書き手に渡すブリーフ
記事を外部のライターに頼むときは、構成案に加えて、上位のページを上回るために何を書くかをブリーフ(執筆の指示書)にまとめます。作るときの規則は 4 つです。
- 上位の分析から、比べても意味の無いページを外す。百科事典・EC モール・SNS・Q&A サイト・行政のページは、自社と同じ条件で競っている相手ではありません
- 自社が書けない話題を借りない。上位のページが扱っていても、自社が提供していないサービスや答えられない内容は見出しに入れません。提案の前に「このサイトはこれを根拠をもって書けるか」を確かめます
- 上位に無い情報(情報ゲイン)を具体的に指定する。「より詳しく」「見やすく」は情報ゲインに数えません。自社の数字・事例・取材で得た手順のように、何を足すかを名指しします
- 内部リンクの行き先を、サイトに実在するページから 3〜5 件選んで指定する
この規則を手順書にすると、次のような骨子になります。
---
name: writer-brief
description: >-
  外部のライターに渡す SEO 記事のブリーフ(執筆の指示書)を作る。
  「ライター向けの指示書を作って」「外注用の記事ブリーフ」「構成と書き方の指示をまとめて」で使う。
  ※自社で取材して書き上げる依頼は記事執筆のスキル、既存記事の直し方は
  リライト診断のスキルへ。
---
# 外部ライター向けブリーフ

## 手順
1. 対象サイトのトップとサイトマップを読み、提供しているサービスを一覧にする
2. 対策キーワードの上位 10 件から、競う相手ではないページを外す
   (百科事典・EC モール・SNS・Q&A・行政)。外した件数と残った件数を書く
3. 残ったページの見出しを話題でまとめ、触れているページの割合で必須・推奨・任意に分ける
4. 手順 1 の一覧に無い話題は、上位にあっても見出しに入れない
5. 上位に無い情報を 3 つ以上、具体的に指定する(自社の数字・事例・手順)。
   用意できないものは【要取材】と書き、推測で埋めない
6. 実在するページから内部リンク先を 3〜5 件選ぶ

## 縮退先
- 上位のページが 5 件未満しか取れないときは、取れた件数で作り、件数を冒頭に書く
- サイトマップが読めないときは、トップページのメニューから一覧を作ったと書く

## 出力
- 検索意図(3 行)/ 競う相手の一覧と、外したページ / 見出し構成と各見出しの字数の目安
- 上位に無い情報の指定 / 内部リンク先 / 使ってはいけない表現(誇大な表現・他社の実名)
この手順書は外部のライターに渡す指示書だけを作り、本文は書きません。自社で取材して書く記事執筆と分けているのは書き手が別の人だからで、取材の代わりに、書けない箇所を【要取材】の印で渡します。
手順 1 でサービスの一覧を先に作らせ、手順 4 でその一覧に無い話題を入れさせないのは、上位の旅行サイトにある「交通手段の比較」のような、自社では根拠を示せない見出しが構成に入るからです。書き手はそれを一般論で埋めるしかなく、記事全体の信頼性が下がります。百科事典・EC モール・SNS・Q&A・行政は、自社と同じ条件で競う相手ではありません。手順 2 でそれらを外させ、外した件数も書かせます。6 件の分析を 10 件と同じ確かさで読ませないためです。「より詳しく」は情報ゲインに数えず、足すものを名指しさせるのが手順 5 です。名指しの無い指示は、ライターの手元で一般論に戻ります。
縮退先を 2 つ置いたのは、上位が 5 件未満でもサイトマップが読めなくても「取得できませんでした」で止めず、件数と出どころを冒頭に書いた指示書を出させるためです。出力の「使ってはいけない表現」は、誇大な形容と他社の実名が公開後に取り消しにくい失敗だからで、他社の実名を出すかどうかは人が決めます。
一次情報は取材で入れる
執筆の中核は、AI が書き手を取材する工程です。取材で引き出すのは、Web を検索しても出てこない社内の情報です。読者がいちばんつまずく点とその解決、実際の事例と数字、競合記事に無い視点、失敗談、読後に起こしてほしい行動。3〜5 往復で一次情報を 3 つ以上引き出し、それを主役にする見出しを置きます。取材で得た数字は「当社の運用実測では」のように出典を宣言し、取材に無い数字は創作しません。対話できない実行(ダッシュボードの自動実行など)では取材ができないので、与件と過去の成果物と Web 調査で書けるところまで書き、取材で埋める箇所を「【要取材】」として本文に残します。質問だけ書いて成果物を作らずに終えるのが、いちばん悪い縮退です。
構成案から下書きまでを頼む依頼文の例です。先に足りない例を示します。
「温泉旅館 子連れ」でSEO記事を書いて。5000字くらいで。この依頼では、上位ページの要約をつないだ記事が返ってきます。取材の工程が無いので一次情報が入らず、宿の実際の設備や数字の代わりに「キッズスペースのある宿を選びましょう」といった一般論が並びます。出典の無い数字が混ざることもあり、公開前に誰かが全部を確かめ直すことになります。
山あいの温泉旅館(客室 20 室、家族連れの予約が全体の 4 割)の自社サイトに載せる
記事を作ります。今日は構成案と下書きまでで、CMS への入稿はしません。

対策キーワード: 温泉旅館 子連れ
読者: 未就学児を連れて初めて温泉旅行をする親
記事のゴール: 子連れで泊まれる宿の選び方が分かり、最後に当館の家族プランを知る

進め方:
1. 検索結果の上位 10 件の見出しを集め、何割のページが触れているかで話題を仕分けてください
   (8 割以上は必須、5〜7 割は推奨、3〜4 割は任意)。取れた件数が 10 件未満なら、
   その件数で分析したと書いてください
2. 構成案を出したら、書く前に私に取材してください。質問は 1 回に 2〜3 問、
   全体で 3〜5 往復までにしてください
3. 取材で得た事実を主役にした見出しを、少なくとも 1 つ置いてください
4. 下書きを書いてください。目安は 6,000 字です

守ること:
- 取材で出なかった数字は書かないでください。当館の数字には「当館の実績では」と出典を付けます
- 他の宿の実名を出して比べないでください
- 上位ページの見出しをそのまま写さないでください
- 分からない箇所は推測で埋めず【要取材】と残してください

出力: 構成案(見出しと、各見出しで答える問い)/ 取材メモ / 下書き / 【要取材】の一覧
進め方の 2 で取材を挟むよう指定したのは、これが無いと、エージェントが構成案からそのまま本文を書き始めるからです。対話できない自動実行でこの依頼文を使うなら、2 を「与件と過去の成果物から書き、取材で埋める箇所は【要取材】で残す」に差し替えます。
取材を挟む執筆の手順書です。書くところまでを受け持ち、公開はしません。
---
name: article-writing
description: >-
  上位ページの分析と、利用者への取材を組み合わせて、一次情報の入った記事を書く。
  「記事を書いて」「ブログ記事」「一次情報で記事を」で使う。
  ※キーワードが未定ならキーワード選定のスキルが先。企画から仕上げまでは記事制作の全工程のスキル。
---
# 記事を書く

## 手順
1. 構成案を受け取る(無ければ構成のスキルを先に呼ぶ)
2. **利用者に取材する**:上位ページに無い実例・数字・失敗談を、
   1 回 3〜5 問で聞く(一度に全部聞かない)
3. 取材で得た内容を、一般論の節に混ぜず独立させる
4. 数字には出典と取得日を付ける。出せない数字は書かない
5. 公開しない。下書きで止めて人に渡す

## やらないこと
- 上位の要約を寄せ集めた「平均のページ」を作らない
取材を手順の 2 に置いているのは、依頼文の進め方 2 と同じ理由です。無ければエージェントは構成案からそのまま本文を書き始めます。手順書にあれば、依頼文に書き忘れた回にも効きます。「一度に全部聞かない」を添えているのは、質問を並べただけで成果物を作らずに終える、いちばん悪い縮退を避けるためです。対話できる実行かどうかは回ごとに変わるので、【要取材】で残す差し替えは依頼文の側に残しています。
手順 4 の「出典と取得日を付け、出せない数字は書かない」は、足りない依頼文の例で起きた失敗を止めるためのものです。出典の無い数字が混ざると、公開前に誰かが全部を確かめ直すことになります。手順 5 の「公開しない」は、作ってよいと公開してよいが別の判断だからです。description では、キーワード未定なら選定のスキルが先、通しの依頼は全工程のスキルへ、と送っています。「記事を書いて」でこの手順書が立つと、難易度の判定と実数の規則を飛ばし、執筆の中でキーワードを決めてしまうからです。読者・ゴール・字数・実名を出さない相手は案件ごとに違うので依頼文に残し、取材の位置と出典と下書きで止める規則は手順書に入れています。
仕上げとレビュー
「人間らしくする」工程は、内容ではなく書き方だけを直します。AI らしさの正体は語彙の重なり・リズムの均一さ・主観の欠如の 3 つ。事実・数値・固有名詞・見出し・表は変えず、文字数は元の ±10% に収めます。検出器を避ける工程ではなく、読みやすさの工程です。レビューは競合上位 3〜5 本を実際に取得して比較し、指摘を「公開ブロッカー・推奨・任意」の 3 段で、必ず根拠(該当行と競合の実例)つきで出します。タイトルの「5 選」が本文で 5 つ回収されているか、数字に出典があるか、クライアントの実名が混ざっていないか、といった静的検査は先に回しておきます。同じ指摘が次の記事でも出るなら、記事ではなく執筆手順の不備です。手順書側へ還流させます。
文体を直す工程の手順書です。書き方だけを受け持ち、内容には触れません。
---
name: article-humanize
description: >-
  書き上がった記事の**書き方だけ**を直す(内容は変えない)。
  「AI っぽさを消して」「文体を整えて」「自然な文章に」で使う。
  ※競合との比較レビューは記事レビューのスキル、新規執筆は記事執筆のスキル。
---
# 文体を整える

## 変えないもの
事実・数値・固有名詞・見出し・表。文字数は元の ±10% に収める。

## 直すもの
- 語彙の重なり(同じ言い回しの繰り返し)
- リズムの均一さ(文末が全部同じ・文の長さが全部同じ)
- 主観の欠如(誰がどう判断したのかが無い)
- 否定で定義する言い回し、大げさな形容、根拠の無い 3 つ並べ、締めの決まり文句

## やらないこと
- 検出器を避けるための工程にしない(読みやすさの工程)
- 事実を活かすために数字を丸めない
「変えないもの」を手順書の先頭に置いたのは、書き方を直す工程で起きる失敗が、内容まで直してしまうことだからです。事実・数値・見出し・表を変えない、文字数は元の ±10%、と先に固定しておけば、リズムを整える勢いで数字が丸められたり段落が要約されたりしません。「直すもの」は語彙の重なり・リズムの均一さ・主観の欠如の 3 つに限りました。「AI っぽさ」の中身を実行者の感覚に任せないためです。「AI っぽさを消して」という依頼は、放っておくと検出器をすり抜ける工程に読まれます。「検出器を避ける工程にしない」の 1 行は、それを止めるためのものです。description で比較レビューと新規執筆を別のスキルへ送っているのは、「文体を整えて」で執筆の手順書が立つと取材から始まり、レビューの手順書が立つと内容の変更を提案するからです。
レビューの工程の手順書です。競合と比べて重大度付きの指摘を出すところまでで、直しません。
---
name: article-review
description: >-
  公開前の記事を競合上位と比べ、重大度付きの修正提案を出す。
  「記事をレビューして」「公開して大丈夫か」「添削して」で使う。
---
# 記事のレビュー

## 手順
1. 先に機械的な検査を回す:タイトルの「○選」が本文で回収されているか、
   数字に出典があるか、クライアントの実名が混ざっていないか
2. 競合上位 3〜5 本を実際に取得して比べる
3. 指摘を 3 段で出す:**公開ブロッカー / 推奨 / 任意**
4. 各指摘に根拠(該当行と競合の実例)を付ける

## 守ること
- 同じ指摘が次の記事でも出るなら、記事ではなく**執筆手順の不備**として戻す
「5 選」の回収・数字の出典・実名の混入は、競合と比べなくても判定できます。手順 1 でこの機械的な検査を先に回すのはそのためです。競合比較の所見と同じ表に並べると、公開を止めるべき 1 件が推奨や任意の指摘に紛れます。手順 2 で競合上位を実際に取得させるのは、根拠に該当行と競合の実例を付けさせるため。指摘を 3 段にしているのは公開の判断を人が行うからで、全部が同じ重さだと、人は全部を直すか全部を無視するかしかできません。守ることの「執筆手順の不備として戻す」を置いたのは、レビューが記事 1 本を見る仕事だからです。そう書いておかないと、同じ指摘が次の記事でも出続け、上流の手順書は誰にも直されません。
新規より、すでに表示されている記事を直すほうが早く伸びます。候補は Search Console の実績から選び、直す前にクリック数が上位 1 割の語を「守るリスト」に控えて、リライトで消さないようにします。SEO の観点で直す入口と CVR(成約率)の観点で直す入口は分けます。同じページでも、見る材料が違うからです。
既存記事を直す——候補を振り分け、指示書にする
既存記事の直し方は、Search Console で見つかった候補の状態によって変わります。著者は次のように振り分けています。
| 候補の状態 | 原因の見立て | 次に行う点検 |
|---|---|---|
| 平均 4〜10 位 | 上位のページと比べて、少し足りない要素がある | 上位 10 件と自社ページの数値(本文の量・見出しの数・画像の数・内部リンクなど)を並べて比べる |
| 平均 11〜20 位 | 扱っている話題そのものが足りない | 上位 10 件の見出しと比べ、欠けている話題と構成を洗い出す |
| 10 位以内で CTR が低い | 順位ではなく、検索結果での見え方 | title と description の文言を見直す。ページの種類が検索結果と合っているかも確かめる |
数値を比べるときは、上位 10 件の値の真ん中の半分(小さい順に並べて 25%〜75% の範囲)を「上位の範囲」とし、自社の値がその範囲より下か、範囲内か、上かで判定します。こうすると、1 件だけ極端に長いページがあっても判定がぶれません。ただし、上位のページに共通する特徴が順位の原因だとは限りません。指示書には「上位はこうなっている」という相関であり、直せば上がる保証ではないと書き添えます。
話題の不足は、構成案を作るときと同じ基準(8 割以上のページが触れている話題は必須)で調べます。そのうえで、上位に無い自社だけの情報は削らずに伸ばします。title・h1・h2 に入っている語は、いまの流入を支えている可能性があります。「消さない語」として指示書の先頭に並べます。
指示書は、書き手がそのまま作業に入れる形にします。次は子連れ向けの記事を直す例です。
| 優先度 | 直す箇所 | 作業の目安 | 具体的な直し方 |
|---|---|---|---|
| 高 | 消さない語 | — | 「子連れ」「貸切風呂」は title・h1 から外さない |
| 高 | 話題の不足 | 2 時間 | 「赤ちゃん連れの食事」の見出しを足し、離乳食の持ち込みと温めの対応を、取材した内容で書く |
| 中 | title | 5 分 | 「子連れ」「温泉旅館」を前半に寄せ、当館の特徴(ベビーベッドの無料貸出)を入れる |
| 低 | 画像の alt | 5 分 | 客室の写真 3 枚に、写っている設備を説明する alt を付ける |
作業の目安を入れておくと、限られた時間でどこまで直すかを店長やディレクターが決められます。
候補の選び方から指示書までを手順書にすると、次のようになります。
---
name: article-rewrite
description: >-
  既存記事を上位ページと比べ、「何をどう直すか」の指示書にする。
  「リライトして」「記事を改善して」「上位と何が違うか」で使う。
  ※CVR の観点は LP 改善のスキル(第 4 章)、新規執筆は記事執筆のスキル。
---
# 記事のリライト指示書

## 手順
1. 候補を検索実績から選ぶ(思いつきで選ばない)
2. **守るリスト**を先に作る:クリック上位 1 割の語と、それを含む見出し
3. 上位ページとの差を、不足・古さ・意図のずれの 3 つに分ける
4. 指示は**節単位**で書く(残す / 書き換える / 追加する / 削る)
5. 直したあとに見る数字と、読み戻す日を書く

## やらないこと
- 本文をすべて書き直さない(順位のあるページを一から作り直すのは損)
この手順書は指示書を出すところまでで、本文を書き直しません。やらないことに「すべて書き直さない」を置いたのは、順位のあるページを一から作り直すのが損だからです。description で CVR の観点を第 4 章の LP 改善へ送っているのは、同じページでも見る材料が違うからです。混ぜると、検索実績の根拠と成約の根拠が 1 つの指示書に並び、書き手はどちらを優先するのか決められません。
手順 1 で候補を検索実績から選ばせるのは、候補の状態(4〜10 位・11〜20 位・CTR が低い)で原因の見立てと次の点検が変わるからです。クリック上位 1 割の語と title・h1・h2 の語は、いまの流入を支えている可能性があります。リライトでそれを消す失敗はいちばん取り返しにくいので、手順 2 で守るリストを先に作らせます。手順 4 の節単位と作業の目安は、限られた時間でどこまで直すかを店長やディレクターが決められる形にするためのものです。手順 5 の「読み戻す日」は、改善を回す節の規則を指示書の段階で決めさせるもので、測ったあとで都合のよい基準を選べないようにします。指示書には、上位の特徴は相関であって直せば上がる保証ではない、と書き添えます。
比較ページを作るときの規則
「A と B の違い」「〇〇 比較」のような検索には、比較表を持つページが選ばれやすくなります。日本で他社の商品やサービスと比べる表示をするなら、景品表示法の考え方に沿う必要があります。消費者庁の比較広告の考え方は、次の 3 つを求めています。主張する内容が客観的に実証されていること。実証された数値や事実を正確かつ適正に引用すること。比較の方法が公正であること。エージェントに比較ページを作らせるときは、次の点を手順に入れます。
- 比べる項目ごとに出典(公式サイトの URL と確認日)を付ける。出典の無い項目は表に入れない
- 価格や設備は「〇年〇月時点」と書き、見直す日を決めておく
- 自社に不利な項目も、同じ基準で表に並べる
- 他社の実名を出すかどうかは人が決める。出さない場合は、宿や店の種類で比べる
依頼文にすると次のようになります。
「子連れで泊まる宿の選び方」の記事に入れる比較表を作ってください。

- 比べるのは宿の種類(大型の温泉ホテル / 客室の少ない旅館 / 貸別荘)です。
  他の宿の実名は出しません
- 項目: 食事の対応 / 貸切風呂 / 部屋での過ごし方 / 料金の目安
- 当館の欄は、添付した設備表と料金表にある内容だけで書いてください
- 種類ごとの傾向を書くときは、根拠にした公的な統計か公式情報の URL と確認日を添えてください。
  根拠が無い項目は空欄にし、「根拠なし」と書いてください
- 当館に不利な項目(大浴場が無いこと)も同じ表に入れてください
- 表の下に「2026 年 9 月時点」と書いてください
依頼のたびにこの条件を書かずに済むように、手順書にしておきます。
---
name: comparison-page
description: >-
  「A と B の違い」「〜 比較」の検索に向けた比較ページを作る。
  「比較ページを作って」「他社との違いをまとめて」で使う。
---
# 比較ページ

## 手順
1. 比べる項目を先に決める(あとから自社に有利な項目を足さない)
2. 項目ごとに**出典(公式サイトの URL と確認日)**を付ける。出典の無い項目は載せない
3. **自社に不利な項目も同じ表に入れる**
4. 表の下に「○年○月時点」と書く

## 守ること
- 主張は客観的に実証されているものだけ。引用は正確に。比較の方法を公正に
- 競合の古い仕様を現行として並べない
この手順書の 4 つの手順は、消費者庁の比較広告の考え方が求める 3 点(客観的な実証・正確な引用・公正な比較方法)を、依頼する人が法規を知らなくても満たせるように作業へ翻訳したものです。手順 1 で項目を先に決めさせ、手順 3 で不利な項目も同じ表に入れさせるのは、比較の方法を公正にするためです。依頼文の例で当館に大浴場が無いことを表に入れさせたのも、この規則を依頼の側から支えるためです。手順 2 で出典の無い項目を載せさせないのは、実証されていない主張を表に入れないためで、空欄を推測で埋めない規則の比較表版でもあります。
手順 4 の「○年○月時点」と「競合の古い仕様を現行として並べない」は、価格と設備が日単位で変わるからです。商品ページの節で述べたとおり、日付の無い価格表は翌日には嘘になります。他社の実名を出すかどうかは手順書に書かず、依頼文に残しています。案件ごとに人が決めることだからです。比べる対象・項目・自社の欄の根拠にする資料も依頼文にあり、手順書が持つのは案件が変わっても同じ法規と日付の規則だけです。
まとめて生成するときの品質ゲート
地域 × サービス、用語集、連携先の一覧のように、データからページを大量に作る方法(プログラマティック SEO)では、1 ページずつの取材もレビューもできません。代わりに、公開の前に機械で確かめられる条件を決めておきます。
- 任意の 2 ページを比べて、地名や商品名を差し替えただけではない内容が 3〜4 割以上あるか
- 各ページに、そのページにしか無いデータ(価格・所在地・実績・口コミなど)が入っているか。データが欠けているページは生成しない
- 公開は 50〜100 ページずつ行い、2〜4 週間インデックスと順位を見てから次を出す
- 生成したページのうち 5〜10% を人が読んで確かめる
数値は著者の運用上の目安で、Google が決めた基準ではありません。公式にあるのは「価値の無いページを大量に作らない」という方針だけです。だからこそ、自分で決めた数値を手順書に書き、生成のたびに同じ基準で止めます。
公開の条件を先に決める手順書の骨子です。
---
name: programmatic-pages
description: >-
  データからページを大量に作るときの計画と、公開前の品質ゲートを決める。
  「地域 × サービスのページを作りたい」「用語集を作る」「テンプレートで量産」で使う。
---
# まとめて生成するページ

## 先に決める
- URL の規則と、ページ間のリンクの張り方
- **公開の条件**(機械で確かめられるものだけ)

## 品質ゲートの例
- 入れ替えテスト:地名を別の地名に入れ替えても文章が成り立つなら、公開しない
- そのページにしか無い内容(写真・人・行き方・実際の声)が 1 つ以上あるか
- 重複した本文の割合がしきい値を超えていないか

## やらないこと
- すべてを一度に公開しない(少数で出し、登録と流入を見てから広げる)
この手順書は、まとめて生成するページの計画と公開の条件を決めるものです。1 ページずつの取材もレビューもできないので、代わりに公開の前で止める条件だけを持ちます。「先に決める」の URL の規則と公開の条件は値が案件ごとに違うので、手順書が持つのは条件の型です。
品質ゲートの数値を手順書に書いているのは、それが Google の基準ではなく著者の運用上の目安だからです。公式にあるのは「価値の無いページを大量に作らない」という方針だけで、基準を自分で決めた以上、生成のたびに同じ数値で止めないと、通した回と止めた回の境目を説明できません。地名を差し替えただけのページは、見た目には整っているぶん、人の目では見分けにくいものです。入れ替えテストを例の先頭に置いたのはそのためです。「一度に公開しない」は、50〜100 ページずつ出して 2〜4 週間見る運用を、依頼文に毎回書かなくても守るためです。全部を一度に出すと、条件を誤っていたときに直す対象が数百ページになります。
CMS へは下書きで入れる
仕上がった記事は CMS へ下書きとして入稿します。WordPress なら REST API に、アプリケーションパスワード(https 経由でしか使えない)で投稿を作ります。投稿の状態は引数にせず、下書きに固定します。「作ってよい」と「公開してよい」は別の判断で、広告の「作成は停止状態で、配信開始は改めて確認」と同じ境界です。入稿のツールもパーミッション(外部反映の前に人の確認を求める Claude の設定。第 2 章)で確認の対象(ask)にし、確認画面で許可するまで CMS には何も作られません。公開は人が、いつもの管理画面で行います。
著者のマーケティングエージェントでは、記事 1 本の全工程を 1 つの入口が持ち、キーワード調査 → 構成案 → AI 取材による執筆 → 人間らしく → 競合比較レビュー → WordPress の下書き入稿の順で、工程ごとの担当へ委譲します。WordPress 側へ用意した口は下書きを作る 1 つだけで、公開・更新・削除の口は増やしていません。公開まで自動化したくなったら、この境界を引いた理由から設計し直すと決めています。口を 1 つ足すのは簡単ですが、戻すときには公開済みの記事が残っています。
記事 1 本の全工程を受け持つ入口の手順書は、次のようになります。各工程は、この節で示した手順書へ渡します。
---
name: article-pipeline
description: >-
  記事 1 本を、与件把握から仕上げまで工程ごとのスキルへ渡しながら仕上げる。
  「記事を 1 本作って」「企画から仕上げまで通しで」で使う。
---
# 記事制作の全工程

## 工程と渡す先
1. 与件把握(読み手・目的・禁止事項・公開先)——このスキル
2. キーワードの確定 → キーワード選定と実数値のスキル
3. 構成 → 記事構成のスキル
4. 執筆(取材含む) → 記事執筆のスキル
5. 文体とレビュー → 文体のスキル、レビューのスキル
6. 公開は**下書きで入れる**(公開ボタンは人が押す)

## 守ること
- 各工程の出力をファイルで渡す。工程を飛ばさない
この手順書は入口で、自分で行うのは与件把握だけです。渡す先を固定しているのは、サイト全体監査の入口と同じ理由です。工程ごとの手順書にはそれぞれ守らせたい規則があり(取材、出典、3 段のレビュー)、入口が自分で書き始めるとその規則を素通りします。入口が 2 つあると成果物の形が実行ごとに変わり、先月の記事と比べられません。description の「通しで」と、記事執筆の側の「企画から仕上げまでは全工程のスキル」は、この境界を依頼の言い方で分けるためのものです。
工程 6 で下書きに固定し、公開ボタンは人が押すと書いているのは、CMS 側に用意した口が下書きを作る 1 つだけだからです。公開・更新・削除の口は増やしていません。口を 1 つ足すのは簡単ですが、戻すときには公開済みの記事が残っています。この境界は、広告の「作成は停止状態で、配信開始は改めて確認」と同じです。守ることに「工程を飛ばさない」を入れたのは、取材とレビューが飛ばされやすいため。取材を飛ばせば一次情報が入らず、レビューを飛ばせば公開の判断材料が無いまま下書きが入ります。レビューで大幅な書き直しになったとき、執筆へ戻る経路には読める形の成果物が要ります。出力をファイルで渡させるのはそのためです。
サイトマップ送信・インデックス送信は外部反映
サイトマップの送信も再クロール依頼も、Google に「読み直せ」と伝える取り消せない操作です。送信のツールはパーミッションで確認の対象(ask)にします。読み取り(一覧・URL 検査)は確認なし(allow)でかまいません。送信の「成功」は受理の意味で、クロールは即時ではありません。数分〜数時間後に一覧で最終取得日時とエラー件数を確かめます。
| 経路 | 届く先 | 使いどころ | 注意 |
|---|---|---|---|
| Search Console のサイトマップ送信 | サイト全体の案内図を出す・更新する | 送信 = 受理。サイトマップに noindex や転送先の URL を入れない | |
| Indexing API | 求人(JobPosting)と配信イベント(BroadcastEvent)のページだけ | 公式が用途を限定している。一般の記事に使う経路ではない | |
| IndexNow | Bing・Naver・Seznam・Yandex など | 更新した URL を 1 回の送信で参加エンジンへ知らせる | Google は参加していない。所有確認は鍵をサイト上に公開して行うので、送る前に公開を実測で確かめる |
一般の記事を Google に早く読ませたいなら、サイトマップの更新と、管理画面からの URL 検査 → インデックス登録リクエストが正攻法です。検索エンジンごとにインデックス経路が違い、1 つの送信で全部には届きません。
読み取りと送信の境目を、コマンドで見ておきます。前に挙げた 2 本の CLI では次のように分かれます。
# 読み取り(確認は要らない)
gsc sitemaps list                                  # 登録済みの一覧・最終取得日時・エラー件数
gsc inspect https://example.com/blog/post-1        # 1 URL のインデックス状況
bwt sitemaps list

# 外部反映(確認画面で人が許可してから実行する)
gsc sitemaps submit https://example.com/sitemap.xml
bwt submit https://example.com/blog/post-1         # bwt submit quota で残り回数を先に見る
この 2 つの違いは、コマンドの文字列を読まないと分かりません。 gsc sitemaps の後ろが list か submit かだけで、外部に届くかどうかが変わる。第 2 章で「読み取りと書き込みを別の名前のツールに分ける」と書いたのは、この判定を正規表現に任せないためです。エージェントに使わせるなら、list と submit を別のツールにして、submit の側だけをパーミッションで確認の対象(ask)にします。CLI のまま使わせるなら Bash(gsc sitemaps submit *) のように送信のコマンドを ask に書く方法もありますが、Bash のルールはコマンドの書き方が変わると一致しません(第 2 章)。
送る前にサイトマップの中身を確かめる
送信には承認を通しますが、中身の点検は読み取りだけなので、自動で回してかまいません。Google のサイトマップのドキュメントにある規則と、運用で起きやすい誤りを並べます。
- 1 ファイルは 50,000 URL まで、または非圧縮で 50MB まで。超えるならファイルを分け、それらをまとめるサイトマップインデックスから指す
- URL は省略の無い絶対 URL で書き、canonical にした URL だけを入れる。noindex のページ、転送元の URL、200 以外を返す URL は入れない
priorityとchangefreqは Google が無視する。lastmodは、正確だと確かめられる場合に使われる。全ページが同じ日付なら、ファイルを作った日が入っているだけなので直す- robots.txt に
Sitemap:の行で場所を書いておく。Search Console で送信しなくても、クローラーが見つけられる - サイト内のリンクをたどって見つかったページとサイトマップを突き合わせる。サイトマップにしか無い URL(どこからもリンクされていない)と、サイトマップに無い重要なページを、両方拾う
点検を頼むときの依頼文の例です。
山の湯旅館のサイトのサイトマップを点検してください。今回は点検だけで、送信はしません。

- 対象: robots.txt に書かれたサイトマップと、そこから指されているファイルすべて
- 各 URL を実際に取得し、ステータスが 200 以外、noindex、canonical が別の URL、
  転送される URL を、理由つきで一覧にしてください
- lastmod がすべて同じ日付になっていないかを確かめてください
- サイト内のリンクをたどって見つかったページと突き合わせ、
  「サイトマップにあるがリンクされていない」「リンクされているがサイトマップに無い」を分けてください
- 取得できなかった URL は理由を書き、「問題なし」に数えないでください
- 直したサイトマップの案を出す場合も、送信は私が承認してから行います
最後から 2 行目が無いと、タイムアウトで取得できなかった URL が「問題の無い URL」として数えられます。問題の件数が実際より少なく報告され、点検が済んだように見えます。
サイトマップの点検と作成を受け持つ手順書です。読み取りと生成までで、送信は含みません。
---
name: sitemap-build
description: >-
  既存のサイトマップを検証するか、業種別の雛形で新規に作る。
  「サイトマップを作って」「サイトマップを見て」で使う。
  ※送信は外部反映なので、承認を通して検索実績のスキルから行う。
---
# サイトマップ

## 手順
1. 入っている URL を数え、**登録してほしくないページ**が入っていないか見る
   (検索結果ページ・絞り込みの結果・テストページ)
2. 正規の URL と一致しているかを確かめる(末尾のスラッシュ・パラメータ)
3. 最終更新日が全件同じ日になっていないか見る(自動生成の事故)
4. 件数が多いときは種類ごとに分ける

## 出力
入っている件数・種類別の内訳・除外すべき URL の一覧
送信をこの手順書に入れず、description で承認を通す別の経路へ送っているのは、送信が取り消せない外部反映だからです。点検は読み取りだけなので確認なしで自動で回してよく、送信は確認の対象にします。2 つを 1 つの手順書に入れると、点検のつもりの実行が送信まで進むか、点検のたびに確認画面が出るかのどちらかになります。読み取りと送信の違いはコマンドの文字列でしか分からず、その判定を正規表現に任せないと第 2 章で決めたので、手順書の単位でも分けています。
サイトマップに入れてよいのは、正規にした URL だけです。手順 1 で登録してほしくないページを探させ、手順 2 で正規の URL との一致を見させるのはそのためです。手順 3 の「最終更新日が全件同じ日」は自動生成の事故の典型で、ファイルを作った日が入っているだけの日付は使われません。出力は件数・内訳・除外すべき URL の一覧にしました。送信を承認する人が、その画面で判断できる材料だからです。「取得できなかった URL を問題なしに数えない」は、この章では依頼文の側に残しています。点検を毎月回すようになれば、流入分析の依頼文と同じく手順書へ移す規則です。
改善を回す——ベースライン・施策の一覧・読み戻し
監査・流入分析・順位計測は、それぞれ単独でも成果物を出します。成果につながるのは、それらを 1 つの周期でつないだときです。著者は SEO の改善を、現状把握 → 施策の一覧(バックログ)→ 実行 → 効果測定、の周期で回しています。次の節のアドバイザーは、この周期に入れる候補を毎日機械的に出す仕組みです。
施策の前にベースラインを取る
施策を打つ前の数字(ベースライン)が無いと、効果を測れません。順位の実測と Search Console の実績は、施策の前に必ず取ります。Search Console の権限がまだ無い案件では、順位の実測だけで始め、「プロパティの権限をもらう」を施策の一覧の先頭に置きます。数字が欠けていることを隠さないためです。
周期の深さは案件によって変えます。初回や四半期の見直しでは全体監査まで行います。月次は流入分析と順位計測を中心にし、順位が急に落ちたときは該当ページの直しだけに絞ります。ただし、どの深さでもベースラインの取得と効果測定は省きません。
所見を施策の一覧にまとめる
監査や分析が出すのは所見です。施策にするには、次の 4 つを足します。
- 優先度: 見込める効果(Impact)と確からしさ(Confidence)を 0〜10 で付け、掛け合わせて並べる。材料が欠けた項目は 0 点にせず、「未取得のため除いて算出」と書く
- 順番: 他の施策の前提になるものを先に置く。ページがインデックスされていない、noindex が誤って付いている、といった問題は、地味でも先頭に来る。インデックスされていないページには、記事の改善も AI 検索の対策も効かない
- 依存: 並行して進められる施策と、順番が決まっている施策を分ける
- 失敗の判定: 何がどうなったらこの施策は効かなかったと判断するかを、1 文で書く
一覧の 1 行は、たとえば次の形にします。
- id: b-012
  title: 家族プランのページに、離乳食と赤ちゃん連れの食事の対応を追記する
  target:
    url: /plan/family/
    queries: [温泉旅館 子連れ, 子連れ 温泉 離乳食]
  finding: 平均 13.2 位。上位 10 件のうち 8 件が食事の対応に触れているが、当館のページには無い
  impact: 7          # 表示回数が多く、10 位以内に入ればクリックが増える見込み
  confidence: 6      # 取材で一次情報を出せる
  priority: 42       # impact × confidence
  depends_on: []
  baseline:
    window: 2026-08-01〜2026-08-28
    position: 13.2
    clicks: 41
    source: Search Console(終了日は取得日の 3 日前)
  failure_if: 公開から 56 日後の平均掲載順位が 11 位より下のまま
  status: 未着手
failure_if を書いておくと、効果測定の日に「効いたかどうか」を議論し直さずに済みます。書かずに進めると、測ったあとで都合のよい基準を選べてしまいます。
流入が落ちたときの切り分け
流入が減ったときは、原因を決める前に、関係の無い要因を順に外していきます。
- どのクエリ・どのページで落ちたかを分ける。直近 28 日の実績と直近 90 日の実績を取り、90 日側を 28 日分に換算して(28÷90 を掛ける)比べると、3 割以上落ちたクエリを拾えます
- 季節性を外す。宿泊や観光は月によって検索数が大きく動くので、直前の期間だけでなく、前年の同じ期間とも比べる
- 計測の変化を外す。タグの付け替え、見ているプロパティの変更、Search Console の集計の遅れ(直近 2〜3 日)
- サイトの変更を外す。同じ時期のテンプレートの変更やページの削除を、監査の節で述べた差分の記録と突き合わせる
- 外の要因を外す。テレビや SNS で取り上げられたことによる指名検索の増減、広告やキャンペーンの開始と終了
ここまで外しても説明できない下落だけを、順位の変動や競合の変化として調べます。
効果は決めた日に読み戻す
SEO の変更は効くまでに時間がかかるので、公開した直後には結果を判断しません。変更の種類ごとに、効果を確かめる日(読み戻しの時期)を先に決めておきます。著者は次の間隔を使っています。
| 変更の種類 | 読み戻す時期 |
|---|---|
| 既存記事の改善 | 7・14・28・56 日後 |
| 新しい記事 | 14・28・56・90 日後 |
| テクニカルの修正 | 最初の 7 日は毎日、その後 28 日後 |
| AI の回答での言及 | 毎週(回答の揺れが大きいので、1 回の結果では判断しない) |
読み戻しの記録には、変更の内容・担当・対象のページとクエリ・ベースラインの期間・比べた期間・参照したデータの出どころ・判断を残します。判断は「採用する」「続けて様子を見る」「元に戻す」「効果を確かめられない」の 4 つから選びます。4 つ目を用意しておくのが要点です。効いたとも効かなかったとも言えない結果を「採用」に数えると、根拠の無いやり方が次の施策の手順に入り込みます。
この周期全体を回す入口を手順書にすると、次のようになります。
---
name: seo-improvement
description: >-
  サイトの SEO 改善を、現状把握から効果測定まで工程ごとのスキルへ渡しながら回す。
  「SEO を改善して」「検索流入を増やしたい」「順位が落ちたので立て直したい」で使う。
---
# SEO 改善の全工程

## 工程
1. 計測が入っているかを確かめる(入っていなければそこから)
2. **現状把握を省略しない**:流入の分析と順位の基準値を先に取る
3. どの段で詰まっているかを判定する(段の判定のスキル)
4. 施策を一覧にし、効果 × 手間で並べる
5. 実行(リライト / 新規 / テクニカル)→ 公開は人が押す
6. **読み戻す日を決めてから実行する**

## 守ること
- 施策の実施日を記録する(後から因果を語るのに要る)
- 1 か月で成否を断定しない
この手順書は日本語運用の PDCA の入口で、自分では監査も執筆もしません。監査の節で「入口を増やさない」と決めたとおり、改善の周期に入る仕事はここから各手順書へ渡します。description に「順位が落ちたので立て直したい」を入れているのは、その依頼が順位計測やリライトに直接着くと、原因を決める前に関係の無い要因を外す切り分けが飛ぶからです。
工程 2 を「省略しない」と強調したのは、ベースラインが無いと効果を測れないからです。Search Console の権限が無い案件では順位の実測だけで始め、権限をもらうことを施策の先頭に置いて、数字が欠けていることを隠しません。工程 3 に段の判定を挟むのは、飛ばすとテクニカルの指摘が 40 件並ぶレポートが返るからです。工程 6 の「読み戻す日を決めてから実行する」は、失敗の判定を先に書いておかないと、測ったあとで都合のよい基準を選べてしまうためです。守ることの「実施日を記録する」は、流入が落ちたときの切り分けにも、順位の変化と施策の実施日を並べてから因果を語る規則にも、この日付が材料として要るからです。新しい記事なら 90 日後まで読み戻すので、「1 か月で成否を断定しない」も守ることに入れました。効いたと言えない結果を「採用」に数えると、根拠の無いやり方が次の施策の手順に入り込みます。
アドバイザー——機械的な提案に生成 AI を使わない
ダッシュボードに常時出す「次にやること」は、Search Console の実測から機械的に組みます。材料は 3 グループだけです。
| 型 | 条件の例 | 提案 | 優先度 |
|---|---|---|---|
| あと一歩 | 平均 11〜20 位で表示回数が一定以上 | 表示されているページを 1 つに決めて足りない見出しを足し、関連ページから内部リンクを張る | 上積み見込みクリックの上位数件を高 |
| クリック率 | 10 位以内なのに、その順位帯の目安 CTR の 6 割に届かない | 順位ではなく文言を直す。タイトルと説明文を、探しているものだと一目で分かる表現に | 中 |
| 順位下落 | 前期比で 3 位以上落ちた | その期間に加えた変更と、いま上位にいる他社のページを見比べる。削っていたら戻し、他社が増やしていたら足す | 5 位以上の下落を高 |
上積み見込みは「表示回数 × 目標順位の目安 CTR − いまのクリック」で概算し、目安 CTR は 1 位で 3 割弱、10 位前後で数 % といった表を持ちます。「高」を件数で固定するのには理由があります。閾値にすると、流入の小さい案件では高が 1 件も出ず、大きい案件では全部が高になるからです。同時に出すのは 5 件まで。読み切れない枚数は 1 枚も読まれません。却下した提案は 2 週間ほど出しませんが、無期限にはしません。却下は「今は要らない」であって「二度と要らない」ではないからです。
ここに生成 AI を使いません。同じデータから昨日と今日で違う提案が出ると、利用者からは壊れたのか改善したのか読めなくなります。並び順も決定的にします。優先度 → 重み → 型 → クエリ名まで見て並べないと、同点の提案が日によって出たり消えたりします。課題文に出す数字は根拠行の値そのもので、取れなかった項目は文に入れません。無い項目に 0 を入れると「表示 0 回」「順位 0 位」という、実測に無い数字が課題文に出てしまいます。CTR の単位変換はここでも 1 箇所。実測を取る段でパーセントに直したら、その先で 100 倍し直しません。
Search Console が読めないときは提案を 1 件も作らず、「未取得」と対処法を返します。そのとき既存の提案は消しません。データが取れないことと課題が解決したことは別です。画面では「提案がありません(いま出せる打ち手が無い)」と「データが読めていません(繋ぐまで何も出ない)」を書き分けます。この 2 つは次の一手が正反対になります。提案は 1 クリックでタスクにして実行でき、根拠の実測値も同じ場所で開ける形にします。
著者のマーケティングエージェントでは、この提案フィードを SEO の画面の先頭に置き、毎日 1 回自動で作り直しています。材料が検索の実測だけなので、SEO を使わない設定の案件では画面ごと出しません。繋ぐ手段が画面のどこにも無いまま「更新しても何も出ない」カードが残るのを避けるためです。
AIO・GEO・LLMO——AI の回答に選ばれる
AI が検索結果をまとめて答える場面が増え、そこに自社が出るかを扱う呼び名も増えました。国内でよく使われるのは AIO・GEO・LLMO の 3 つです。この節では、3 つが何を対象にしているかを分けたうえで、それぞれの対策と、効き方を理解するための 2 つの仕組み(クエリファンアウトとコサイン類似度)を説明します。
従来の SEO が「検索結果の 1 ページ目に載る」ための取り組みだとすれば、AI の回答は複数の情報源をまとめて 1 つの答えを作ります。問われるのは「何位か」ではなく「答えの材料に選ばれるか」です。答えは毎回同じにならないので、「引用させる」ではなく「引用される確率を上げる」と捉えます。確実に載せる方法はありません。そう言い切る業者は疑ってください。
AIO・GEO・LLMO の違い
3 つは、対象にする AI の範囲が順に広がる関係にあります。
| 呼び名 | 元の語 | 対象 | 答えの作られ方 | 何を測るか |
|---|---|---|---|---|
| AIO | AI Overviews 対策 | Google 検索の「AI による概要」と AI モード | Google の検索インデックスから、通常のランキングの仕組みで取ったページをもとに答える | AI による概要・AI モードで、引用元のリンクに出るか |
| GEO | Generative Engine Optimization | 検索してから答える生成 AI 全般(ChatGPT の検索、Perplexity、Copilot、Claude の Web 検索、Google の AI 機能を含む) | 各社の検索(自社のインデックスや提携先の検索エンジン)で集めたページをもとに答える | 検索が走った回答で、言及・引用されるか |
| LLMO | Large Language Model Optimization | 大規模言語モデルそのもの。検索せずに答える場面を含む | 検索した結果に加えて、学習で覚えた知識から答える | 検索の有無を問わず、ブランドが正しく知られ、推薦されるか |
呼び名が広まった順番も、おおむねこの並びです。GEO は 2023 年にプリンストン大学などの研究者が論文で名付けた言葉で、生成 AI の検索エンジン全般を対象にしました。AIO は 2024 年に Google が AI による概要を日本でも始めたころから、国内で「AI Overviews 対策」の意味で広く使われました。LLMO は、検索しない回答やモデルの知識まで含めて扱うために使われるようになった呼び名です。
呼び名の使い方は統一されていません。AIO を「AI Optimization」の略として 3 つ全部を含む総称に使う人もいれば、AEO(Answer Engine Optimization)を GEO とほぼ同じ意味で使う人もいます。提案書や社内の文書では、呼び名ではなく「どの AI の、どの回答で、何を測るか」を書きましょう。上の表の右 2 列を書いておけば、呼び名が違っても話が食い違いません。
もう 1 つ押さえておくことがあります。Google は生成 AI 検索向けの最適化ガイドで、Google 検索から見れば生成 AI 検索への最適化も SEO である、と書いています。AIO は SEO の延長として扱い、GEO と LLMO で初めて Google 以外の事情が加わる、と整理しておくと、同じ施策を名前を変えて二重に行わずに済みます。
AI の回答はどう作られるか
3 つの違いは、回答の作られ方を図にすると分かりやすくなります。
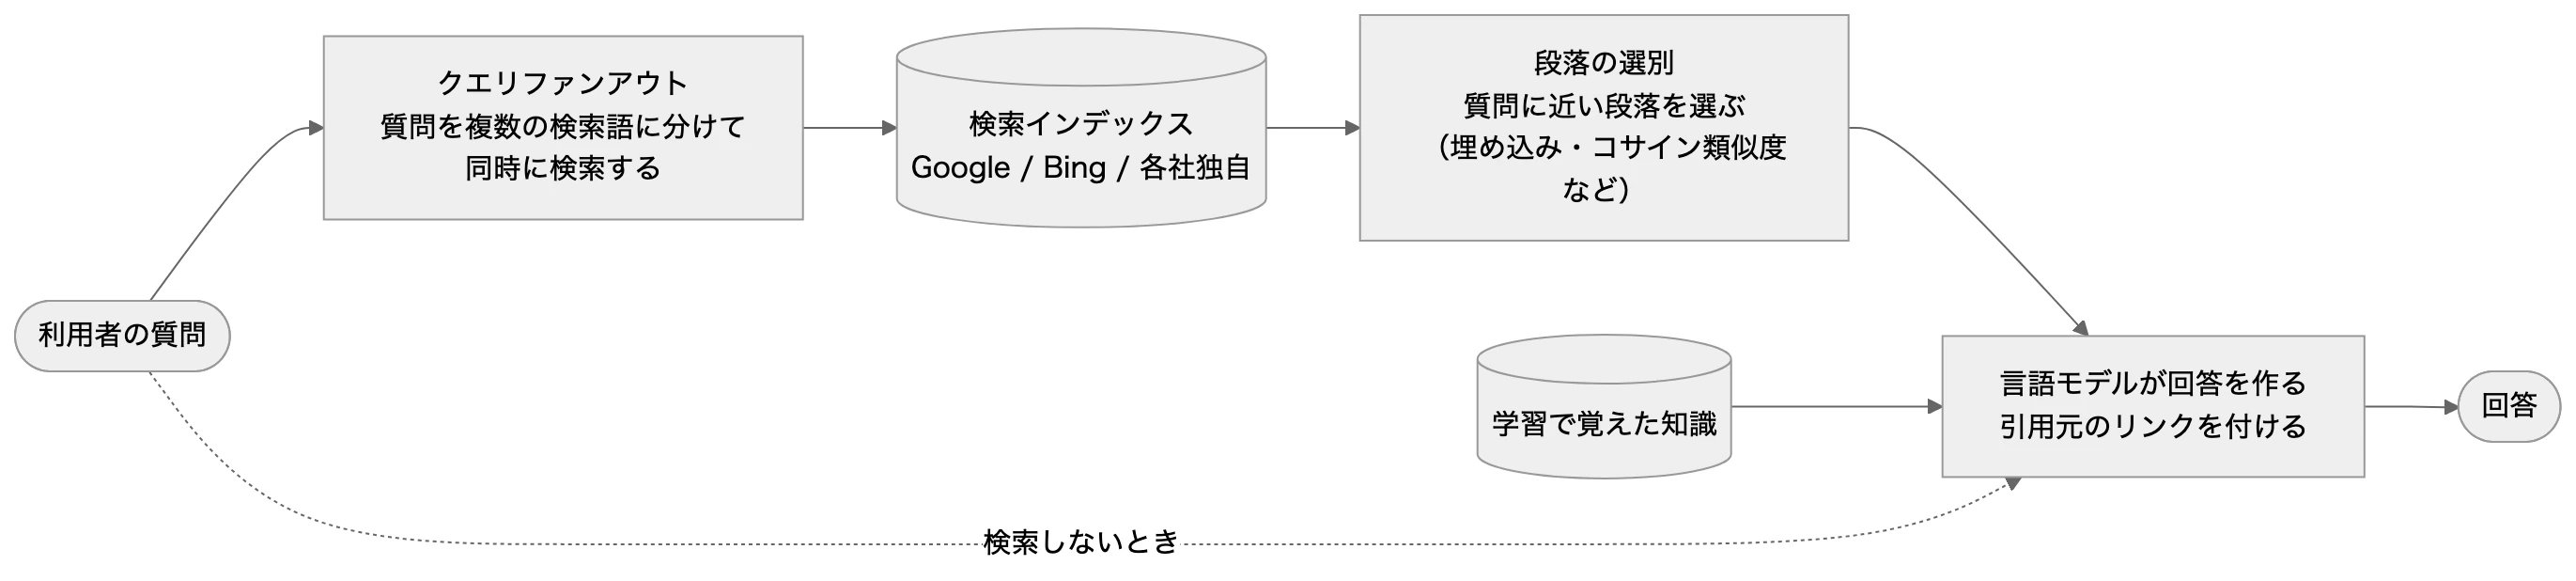
図は横にスクロールできます。図を原寸で開く
図の元になった mermaid を見る
flowchart LR
  Q(["利用者の質問"]) --> FO["クエリファンアウト<br/>質問を複数の検索語に分けて<br/>同時に検索する"]
  FO --> IDX[("検索インデックス<br/>Google / Bing / 各社独自")]
  IDX --> RET["段落の選別<br/>質問に近い段落を選ぶ<br/>(埋め込み・コサイン類似度など)"]
  RET --> GEN["言語モデルが回答を作る<br/>引用元のリンクを付ける"]
  KN[("学習で覚えた知識")] --> GEN
  Q -. "検索しないとき" .-> GEN
  GEN --> A(["回答"])
AIO と GEO が扱うのは、図の上の流れ(検索 → 段落の選別 → 回答)です。LLMO はこれに加えて、「学習で覚えた知識」も対象にします。検索しないで答えた回答に自社が出るかどうかは、モデルが学習した時点の Web で自社がどう書かれていたかで決まります。
図の中の 2 つの処理、クエリファンアウトと段落の選別を、次に説明します。どちらも AI 検索に特有の処理で、従来の SEO の考え方だけで対策を立てると見落とします。
クエリファンアウト: 1 つの質問が複数の検索になる
クエリファンアウト(query fan-out)は、AI が利用者の質問を複数の関連する検索語に分け、同時に検索して結果を集める処理です。Google は、AI による概要と AI モードの両方がこの方法を使うことがあると公式ドキュメントに書いています。AI モードは質問をサブトピックに分けて多数の検索を同時に行い、さらに詳しく調べる機能(Deep Search)では数百回の検索を行うと説明されています。ChatGPT や Claude の Web 検索も、1 つの質問に対して検索を複数回行うことがあります。後の節の計測例で、1 つのクエリに対して queries_executed が 2 件記録されているのはこのためです。
例を挙げます。「子連れで泊まりやすい温泉旅館を教えてください」という質問は、たとえば次のような検索に分かれます。
- 温泉旅館 子連れ おすすめ 〇〇県
- 温泉旅館 キッズスペース 貸切風呂
- 温泉旅館 離乳食 対応
- 温泉旅館 子連れ 口コミ
この仕組みから、対策の考え方が 2 つ変わります。
1 つ目は、競う相手が元の質問ではなく、分かれた検索語ごとの検索結果になることです。元の質問に近い大きなキーワードで上位のページが無くても、「離乳食 対応」の検索で自社のページが上位に出れば、そのページが回答の材料に選ばれる可能性があります。逆に、大きなキーワードで上位でも、分かれた検索語に答えるページが無ければ、回答の中では競合の情報が使われます。
2 つ目は、分かれた検索語を予測して、それぞれに答える段落をサイトに用意する必要があることです。質問を受けた AI が次に何を調べるかは、料金・場所・対象者・比較・口コミ・手順のような切り口に分けて考えると予測しやすくなります。予測は推測なので、計測で実際に投げられた検索語(queries_executed)と突き合わせて直します。Search Console の検索パフォーマンスに出る実際の検索語も材料になります。
一方で Google は同じガイドで、言い回しの違う検索語ごとにページを作り分けたり、AI 向けに書き直したりする必要は無い、とも書いています。分かれた検索語のために別ページを量産するのではなく、既存のページの中に、その問いに答える段落が 1 つあるかを確かめます。
分かれた検索語の予測と、サイトがそれに答えているかの確認は、1 つの担当に任せられます。次はそのスキルの骨子です。
---
name: fanout-coverage-check
description: >-
  AI 検索への質問 1 本について、AI が分けて調べそうな検索語を予測し、
  サイトの各ページがそれに答える段落を持っているかを確かめる担当。
  「AI にこの質問をされたとき、うちのサイトで答えられているか」
  「ファンアウトの網羅を見て」で使う。
  ※言及率の計測そのものは AI 検索の定点計測のスキル、記事の新規作成は記事制作のスキルへ。
---
# クエリファンアウトの網羅確認

## 入力
- 質問(計測に登録済みの文言をそのまま使う)
- 対象サイトの URL の一覧
- あれば: 計測で記録された「AI が実際に投げた検索語」と、Search Console のクエリ

## 手順
1. 質問を、料金・場所・対象者・比較・口コミ・手順・条件の切り口で分け、
   検索語を 8〜15 個予測する。各検索語に「予測」と印を付ける
2. 計測で記録された検索語があれば並べ、予測と一致したものは「実測」に改める。
   予測に無かった実測の検索語は、そのまま追加する
3. 検索語ごとに、答えになる段落がサイトにあるかを、ページを読んで判定する
   - 語句が含まれているだけでは「ある」にしない。問いに言い切りで答えている段落だけを数える
   - 段落の冒頭 2 文で答えが分かるかを見る
4. 答えが無い検索語について、追記するページと、追記する段落の案(200 字程度)を書く

## 出力
- 検索語 / 予測か実測か / 答えている段落のある URL(無ければ「なし」)/ 追記案 の表
- 「実測」の行を先に並べる(予測は外れることがある)

## しないこと
- 検索語ごとに新しいページを作る提案をしない。既存のページへの追記を先に検討する
- 数値や事実を追記案に創作しない。分からない箇所は【要確認】と残す
この手順書は、分かれた検索語の予測と、サイトがそれに答えているかの確認だけを受け持ちます。しないことに「検索語ごとに新しいページを作る提案をしない」を置き、description で記事の新規作成を別のスキルへ送っているのは、Google が言い回しの違う検索語ごとにページを作り分ける必要は無いと書いているからです。入力の質問を計測に登録済みの文言に限っているのは、定点の基準がクエリの文言だからで、ここで言い換えると、後で言及率が動いたときに露出が変わったのか質問が変わったのか読めなくなります。
手順 2 で「予測」と「実測」を分けたのは、AI が作った予測を、実際に投げられた検索語と同じ重さで扱わないためです。分けないと、誰も検索していない検索語のために追記が増えます。検索語を本文に散らしても効きません。回答に使う段落は、問いに答えているかで選ばれます。手順 3 で「語句が含まれているだけでは『ある』にしない」と限定しているのはそのためです。手順 4 で追記案を 200 字程度まで書かせるのは、言及率のレポートで終えず、ギャップ表と追記文面まで落とすため。「数値や事実を創作しない」は、追記案がそのまま本文に貼られることを想定した規則で、分からない箇所は【要確認】で人に戻します。
コサイン類似度: 段落が質問にどれだけ近いか
AI 検索では、集めたページをそのまま全部モデルに読ませるわけではありません。回答に使う段落を選ぶ処理が入ります。その代表的な方法が、文章を数値の並び(ベクトル)に変換する「埋め込み(embedding)」と、2 つのベクトルの向きの近さを測る「コサイン類似度(cosine similarity)」です。
埋め込みでは、意味の近い文章ほど近い向きのベクトルになるように変換します。質問と段落をそれぞれ埋め込み、向きがどれだけ揃っているかを計算すると、「この段落がこの質問にどれだけ関係するか」を数値で比べられます。計算式は次のとおりです。
a が質問のベクトル、b が段落のベクトルです。分子は 2 つのベクトルの内積、分母はそれぞれの長さの積です。値は −1 から 1 の範囲をとり、1 に近いほど意味が近いことを表します。検索語の文字が段落に含まれていなくても、意味が近ければ値は高くなります。「子連れ」と書いていなくても「3 歳のお子さまと泊まれる」と書いた段落は、子連れの質問に近いと判定されます。逆に、キーワードを詰め込んでも中身が質問に答えていなければ、値は上がりにくくなります。
注意点が 3 つあります。
- 各社の AI 検索が、どの埋め込みモデルを使い、どの単位で段落を切り、どの計算で選んでいるかは公開されていません。手元で測る値は、選ばれ方を近似したものです
- 値の大きさそのものには意味がありません。モデルによっては、関係の無い文章どうしでも 0.5 前後になることがあります。同じモデルで測った値を、段落どうしで比べる使い方に限ります
- 値を上げること自体を目的にしないでください。Google は、AI のために文章を小さく分割する必要は無いと書いています。類似度は「どの問いに答える段落が無いか」を見つけるために使い、見つかった問いには、人が読んで分かる段落を書きます
検証には、各社の埋め込み API が使えます。次は Gemini API の埋め込みモデルで、分かれた検索語とページの段落の類似度を一覧にするスクリプトの例です。モデル名と入力の書式は、執筆時点の公式ドキュメントのものです。
# 検索語 × 段落のコサイン類似度を一覧にする
# 必要: pip install google-genai numpy / 環境変数 GEMINI_API_KEY
import numpy as np
from google import genai
from google.genai import types

client = genai.Client()
MODEL = "gemini-embedding-2"

queries = [
    "温泉旅館 子連れ おすすめ",
    "温泉旅館 離乳食 対応",
    "温泉旅館 貸切風呂 子ども",
]
# ページから取り出した段落(見出しと本文の組)
paragraphs = [
    ("お子さま連れのお客さまへ", "3 歳以下のお子さまは添い寝無料です。離乳食は前日までのご予約で…"),
    ("貸切風呂", "家族で使える貸切風呂が 2 つあり、1 回 45 分、予約制です。…"),
    ("アクセス", "駅から送迎バスで 15 分です。…"),
]

def embed(texts):
    res = client.models.embed_content(
        model=MODEL,
        contents=texts,
        config=types.EmbedContentConfig(output_dimensionality=768),
    )
    v = np.array([e.values for e in res.embeddings])
    return v / np.linalg.norm(v, axis=1, keepdims=True)  # 長さを 1 にそろえる

# 質問側と段落側で、公式ドキュメントが示す書式を使い分ける
q = embed([f"task: search result | query: {t}" for t in queries])
p = embed([f"title: {h} | text: {b}" for h, b in paragraphs])

sim = q @ p.T  # 長さ 1 のベクトルどうしなので、内積がコサイン類似度になる
for i, t in enumerate(queries):
    j = int(sim[i].argmax())
    print(f"{t}\t最も近い段落: {paragraphs[j][0]}\t{sim[i, j]:.3f}")
出力を読むときは、検索語ごとに「最も近い段落」の値を見て、ほかの検索語より明らかに低いものを探します。低い検索語は、答える段落がサイトに無い可能性があります。最後は人が本文を読んで判定してください。類似度が高くても、答えになっていない段落はあります。前項の網羅確認のスキルの手順 3 にこの計算を入れると、人が読む段落を先に絞り込めます。
3 つに共通する前提(順番を間違えない)
順番は前提 → 中身 → 一貫性です。読まれていないページは、どれだけ良く書いても引用されません。
- 前提: robots.txt で AI 各社のクローラーを意図せず止めていないか。サーバー側で描画されているか(AI のクローラーは JavaScript を実行しない前提で見ます)。会社・サービス・価格・所在地が機械にも分かる構造化データになっているか。
- 中身: 聞かれ方から設計します。「〇〇でおすすめは」には用途別の比較表、「A と B の違いは」には専用の比較ページ、「〇〇の選び方は」には判断基準つきの選定ガイド。各節の冒頭で言い切りの答えを置き、出典つきの事実・数値を密にします。検索語を本文に散らすのは効かず、逆効果です。
- 一貫性: ブランド名・サービス名の表記を全所有コンテンツで統一し、会社概要・価格の記述を食い違わせません。ぶれると同じ会社の情報として集まりません。
Google 自身は、AI による概要や AI モードに載るために追加の要件も特別な最適化も無く、SEO の基本がそのまま効くと公式ドキュメントで述べています。Google の AI 学習を止めるクローラー指定(Google-Extended)を拒否しても、検索と AI による概要への掲載には影響しません。それらは通常の Googlebot が使うからです。llms.txt(提案サイト)は、サイトの案内を Markdown で置く新しい慣習ですが、執筆時点で主要な AI 検索が引用の材料に使っている証拠は乏しく、有無は報告しても点数の重みは付けません。店舗の案件では、サイトの改修より先に地図まわりを整えるほうが効きます(第 8 章)。
AIO の対策: Google の検索で選ばれるページにする
AIO の対象は Google の AI による概要と AI モードで、使われるのは Google の検索インデックスとランキングの仕組みです。対策は SEO と同じ作業を、次の点を意識して行います。
- 引用元に選ばれる条件を満たす。 Google の公式ドキュメントは、AI 機能で引用元のリンクに出るには、ページがインデックスされ、スニペット付きで検索結果に出せる状態であることが必要だと書いています。
nosnippetやmax-snippetで抜粋を制限しているページは、AI 機能で使われる範囲も制限されます。意図せず付いていないかを監査で確かめます - 分かれた検索語で上位に出る。 クエリファンアウトの項のとおり、材料は分かれた検索語ごとの検索結果から集まります。元の大きなキーワードだけでなく、料金・条件・比較のような具体的な検索語で上位に出るページを持ちます
- E-E-A-T と一次情報を優先する。 Google は最適化ガイドで、実際に効くのは独自の一次情報を含むコンテンツだとしています。ここでいう一次情報は、社内の実績・事例・現場の手順のように、Web を調べても出てこない情報のことです。Web で調べた情報をまとめ直したページは、AI による概要が同じまとめ直しをしているので、引用元に選ばれる理由が薄くなります。この章の前半の品質点検が、そのまま AIO の対策になります
- 構造化データを見えている本文と一致させる。 コンテンツの質の節で述べたとおりです
- Search Console では分けて測れないと知っておく。 AI 機能に出たときの表示回数とクリックは、Search Console の検索パフォーマンスで通常の検索に合算されます。AI による概要に出たかどうかを数えるには、実際の検索結果を開いて確かめる必要があります(順位計測の節と同じ作法です)
GEO の対策: 検索する AI 全般に読まれ、選ばれる
GEO は Google 以外の AI 検索も含みます。各社は自社のクローラーや提携先の検索エンジンで集めたページを使うので、まず各社に読まれていることを確かめます。
- 検索用のクローラーを止めていない。 各社は学習用と検索用でクローラーを分けています。OpenAI は検索に
OAI-SearchBot、学習にGPTBotを使い、GPTBotを拒否しても ChatGPT の検索結果への掲載には影響しないと説明しています。Anthropic は学習用のClaudeBot、検索用のClaude-SearchBot、利用者の依頼でページを開くClaude-Userの 3 つを分けています。学習を止めたい場合でも検索用のクローラーまで止めないよう、robots.txt は名前ごとに書きます - Bing のインデックスに入っている。 Microsoft の Copilot のように、Bing の検索結果を使う AI 検索があります。Bing Webmaster Tools でインデックスを確かめ、更新は IndexNow で知らせます(サイトマップ送信の節)
- 段落の冒頭で答える。 コサイン類似度の項のとおり、回答に使う段落は質問との近さで選ばれます。見出しの直後の 1〜2 文で問いに言い切りで答え、根拠と数値をその後に続けます。段落だけを抜き出しても意味が通るように、「前述のとおり」のような前後への参照を減らします
- 日付と更新を見える形にする。 公開日と更新日を本文に出し、内容が古くなったら更新します。内容を変えずに日付だけを新しくするのは、Google が自己点検の項目で指摘している行為です
- 出典・数値・引用を入れる。 GEO を名付けた論文(Aggarwal ほか、KDD 2024)は、約 1 万件の質問で、書き方の違いが回答での露出にどう影響するかを比べました。結果は下の表のとおりです
| 書き方 | 論文の結果 |
|---|---|
| 引用句を加える(Quotation Addition) | 回答中の露出を測る指標で最も高く、何もしない場合より約 4 割高い |
| 統計・数値を加える(Statistics Addition)、出典を示す(Cite Sources) | 引用句と並んで効果の大きい手法 |
| 出典を示す(検索結果の順位別) | 5 位のページでは露出が 115.1% 増えた一方、1 位のページでは 30.3% 減った |
| キーワードを詰め込む(Keyword Stuffing) | 何もしない場合を下回った |
表の 3 行目は、まだ上位に出ていないページほど、出典を示す効果が大きいことを示しています。中小のサイトにとっては、取り組む理由になる結果です。ただし、この結果は研究用に用意した生成エンジンでの実験です。特定の商用サービスで同じ効果が出ることを保証するものではありません。追加する数値や引用は、自社の実績と確かな出典から取り、無ければ書きません。
LLMO の対策: モデルに正しく覚えられ、推薦される
LLMO では、検索しないで答える場面も対象になります。その場面では、モデルが学習した時点の Web で自社がどう書かれていたかが答えを決めます。サイトの 1 ページを直しても、次にモデルが学習し直されるまで、検索しない回答は変わりません。効果が出るまでの時間が AIO・GEO より長いことを、提案の段階で伝えておきます。
- 社内にしか無い情報を Web に出す。 モデルが自社について覚えられるのは、Web に書かれていることだけです。実績・事例・独自の手順が社内の資料や担当者の中にとどまっていれば、モデルはその会社を、同業の他社と区別のつかない存在としてしか覚えません。ネットで調べた情報をまとめたページを増やしても、モデルがすでに知っていることの繰り返しなので、覚え方は変わりません。公開できる範囲を決めたうえで、社内のノウハウと実績を自社サイトに載せることが LLMO の出発点です
- エンティティを 1 つに揃える。 エンティティ(entity)は、会社・人・商品・場所のように、他と区別して指せる対象のことです。AI は「山の湯旅館」「やまのゆ旅館」「Yamanoyu Ryokan」が同じ宿だと分からなければ、情報を 1 つにまとめられません。表記を自社のすべての媒体で統一し、会社概要・所在地・料金の記述を食い違わせないようにします。構造化データの Organization に、公式 SNS や外部の掲載ページを
sameAsで並べておくと、同じ対象だという対応を機械に渡せます - 第三者のサイトで言及される。 モデルが学習するのは自社サイトだけではありません。業界メディアの記事、口コミサイト、比較記事、地域の観光サイトなど、第三者が自社について書いたページも知識の材料になります。E-E-A-T の権威性と同じく、ページの書き方では増えないので、広報や掲載依頼の施策として管理します。百科事典サイトへの掲載は、掲載基準(信頼できる第三者の情報源による言及)を満たす場合に限ります。宣伝目的で自ら記事を作ると削除され、評判も下がります
- 学習用クローラーの扱いを事業として決める。
GPTBot・ClaudeBot・Google-Extendedなどを拒否すると、以後の学習にそのサイトの内容が使われなくなります。有料記事のように、内容の利用を許したくない理由があれば拒否は妥当です。ただし LLMO の観点では、モデルが自社について学ぶ材料を自分で減らすことになります。どちらを選んだかを記録し、GEO の検索用クローラーとは分けて判断します - 検索なしの回答も測る。 次の言及計測の節では、「検索されなかった回答」を GEO の計測としては不成立と扱います。LLMO では、その回答がモデルの知識を測った結果になるので、別の指標として分けて記録します
3 つの対策を 1 つの依頼で進めるときは、入口のスキルで AIO・GEO・LLMO のどれを見るかを最初に決めさせます。決めずに始めると、Google の検索順位の話とモデルの知識の話が 1 つのレポートの中で混ざります。次は入口のスキルの骨子です。委譲先には、この章で示したページ品質の点検とクエリファンアウトの網羅確認を使います。
---
name: ai-answer-visibility
description: >-
  AI の回答に自社が選ばれるための診断と改善の入口。AIO(Google の AI による概要・
  AI モード)、GEO(検索して答える生成 AI 全般)、LLMO(モデルの知識を含む)の
  どれを対象にするかを決めてから、前提の点検・網羅の確認・計測・改善案を返す。
  「LLMO をやりたい」「AI 検索で出てこない」「AI Overviews に載りたい」で使う。
  ※サイト全体の技術監査はサイト全体監査、記事の新規作成は記事制作のスキルへ。
---
# AI の回答での可視性

## 0. 対象を決める(必ず最初に書く)
- AIO: Google の AI による概要・AI モード。材料は Google の検索インデックス
- GEO: 検索して答える AI 全般。エンジンごとに分けて扱う
- LLMO: 検索しない回答を含む。効果が出るまでモデルの学習を待つ
依頼文から決められなければ AIO と GEO を対象にし、その前提を冒頭に書く

## 1. 前提の点検(3 つ共通)
- robots.txt: 検索用クローラー(Googlebot / bingbot / OAI-SearchBot /
  Claude-SearchBot / PerplexityBot)を止めていないか。学習用は現状を書くだけ(事業判断)
- 本文がサーバー側で描画されているか。nosnippet・max-snippet の指定
- 構造化データが見えている本文と一致しているか。ブランド名の表記が揃っているか

## 2. 中身の点検
- 登録済みの質問ごとに、クエリファンアウトの網羅確認の担当へ委譲する
- 主要ページをページ品質の点検の担当へ委譲し、E-E-A-T の所見を受け取る

## 3. 計測
- 登録済みの質問だけで測る。質問の文言は変えない
- 検索が走った回答(GEO の指標)と、検索なしの回答(LLMO の知識の指標)を分けて集計する
- エンジン間で合算・比較しない

## 4. 出力
- 一言でいうと(3 行)/ 対象(AIO・GEO・LLMO)/ 前提の不備 / 網羅の不足と追記案 /
  計測結果(エンジン別)/ 次に測る日
- 施策ごとに「効果が見えるまでの目安」を書く(AIO・GEO は再クロール後、LLMO はモデルの更新後)

## しないこと
- llms.txt の設置を主な施策にしない(主要な AI 検索が使っている根拠が乏しい)
- 分かれた検索語ごとにページを量産しない
- 計測していない数値を「AI での露出」として書かない
手順 0 で対象を決めさせるのは、効果が出るまでの時間が対象ごとに違うからです。AIO・GEO の施策は、ページが読み直されれば数週間で計測に表れます。LLMO の検索なしの回答は、モデルが更新されるまで変わりません。対象を書かずに月次で比べると、「施策をしたのに変わらない」という誤った評価になります。決められないときに AIO と GEO を既定にし、description に 3 つの呼び名を並べているのは、呼び名の使い方が統一されていない中でも依頼を止めず、対象の判定を手順書の側で行うためです。
手順 1 で前提の点検を中身より先に置いたのは、読まれていないページはどれだけ良く書いても引用されないからです。学習用のクローラーについては「現状を書くだけ」にしました。学習を止めるかどうかは事業の判断です。手順書が解除まで書くと、有料記事のように利用を許したくない理由のある案件で誤った提案になります。手順 3 の 3 つの規則は、言及計測の節で述べた失敗の裏返しです。質問を実行ごとに作ると伸びたのが露出かクエリか読めず、検索されなかった回答を「言及なし」に数えると言及率が実態より低く出て、課金の単位も引用の定義も違うエンジンを足すと意味の無い数字になります。しないことの 3 つは、この章で「効かない」または「確かめられない」と述べたものです。確実に載せる方法は無い以上、根拠の無い約束が報告に入る経路を手順書で塞いでいます。
言及計測——1 サンプルに何を記録するか
「なんとなく載っていない気がする」で終わらせないために、実際に聞いて記録します。3 社(Gemini・OpenAI・Anthropic)の API には、モデルが Web 検索してから答える「検索グラウンディング」の機能があり(Gemini・OpenAI・Anthropic)、登録したクエリを投げて回答と引用元を取り出します。1 クエリ × 1 エンジン = 1 サンプル。記録する形は次のとおりです。
{
  "engine": "gemini",
  "query": "熱海 旅館 おすすめ",
  "searched": true,
  "queries_executed": ["熱海 旅館 人気 2026", "熱海 温泉旅館 口コミ"],
  "brand_mentioned": true,
  "competitors_mentioned": {"A 旅館": true, "B ホテル": false},
  "citations": [{"url": "https://...", "title": "...", "domain": "example.com"}],
  "cited_own": false,
  "answer": "(回答本文。保存は先頭だけ、判定は全文で)",
  "error": null
}
言及の判定は、大文字小文字だけを畳んだ単純な部分一致にします。日本語には単語の境界が無いので、英語向けの単語単位の照合では社名が一致しません。短すぎる語の誤検知は登録側で直せます。判定側を賢くして、なぜ一致したのかが読めなくなるほうがよほど困ります。表記ゆれは 1 行 1 件で登録し、本文は保存のために切り詰めても、判定は切る前の全文で行います。末尾の言及を見落とすからです。
「言及されなかった」と「検索されなかった」を分ける
検索するかどうかはモデルが決めます。執筆時点で検索を強制できると公式に書かれているのは OpenAI だけです。検索が走らなかった回答は素の知識で答えたもので、計測になっていません。これを「言及されなかった」と数えると、言及率(SoV)が実態より低く出ます。しかも回答は返っているので、画面からは正常にしか見えません。
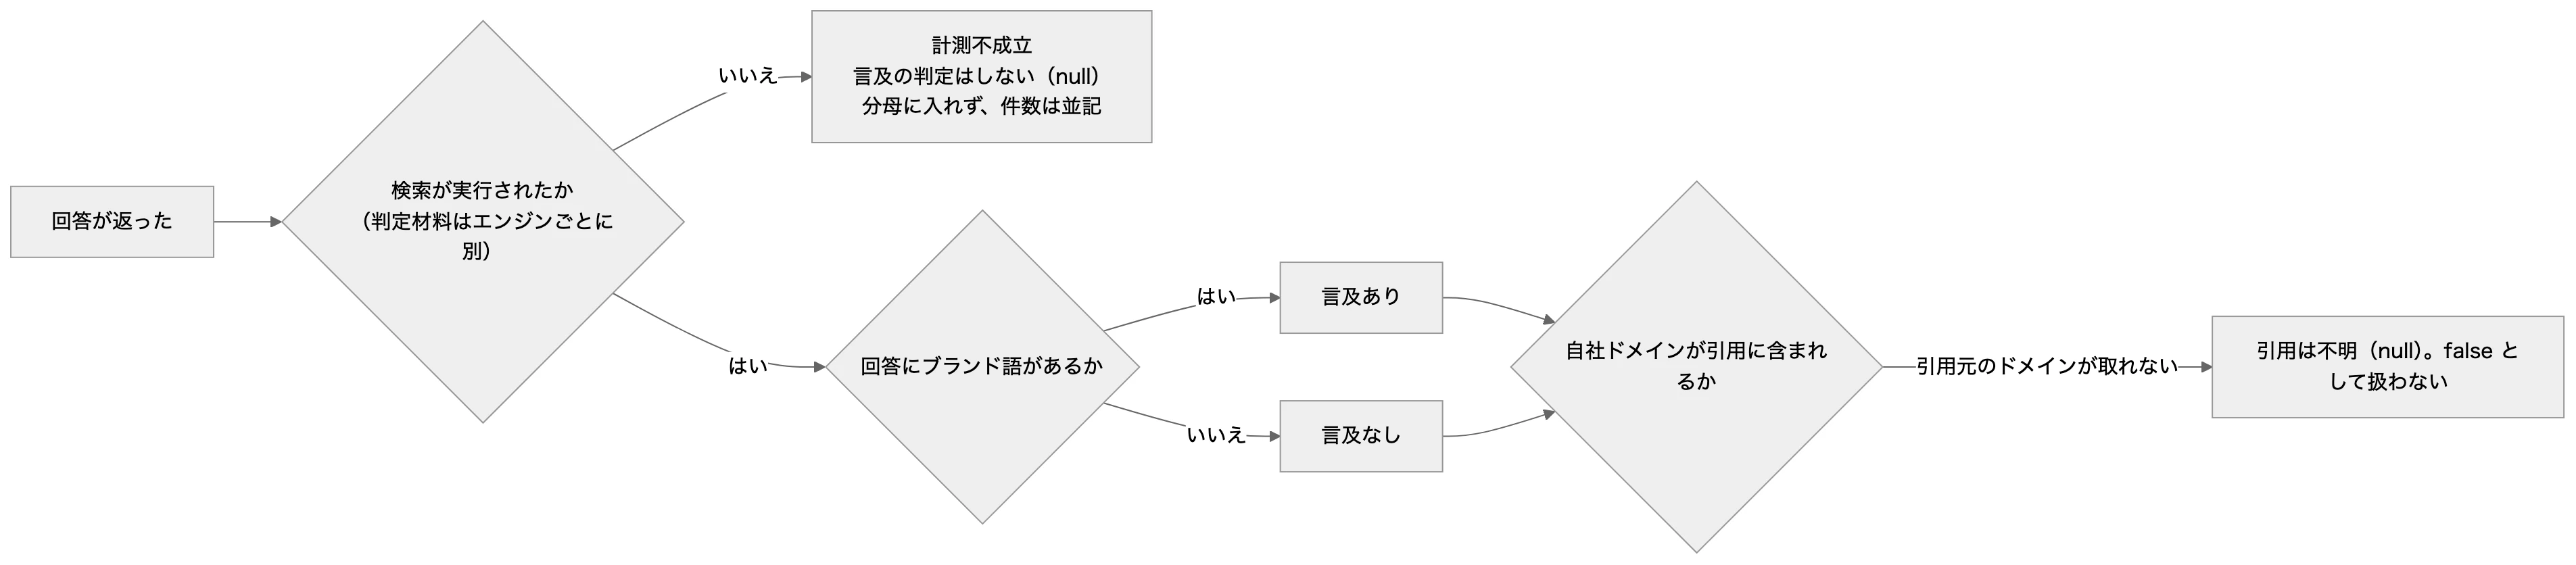
図は横にスクロールできます。図を原寸で開く
図の元になった mermaid を見る
flowchart LR
  ANS["回答が返った"] --> S{"検索が実行されたか<br/>(判定材料はエンジンごとに別)"}
  S -->|"いいえ"| NM["計測不成立<br/>言及の判定はしない(null)<br/>分母に入れず、件数は並記"]
  S -->|"はい"| M{"回答にブランド語があるか"}
  M -->|"はい"| YES["言及あり"]
  M -->|"いいえ"| NO["言及なし"]
  YES --> C{"自社ドメインが引用に含まれるか"}
  NO --> C
  C -->|"引用元のドメインが取れない"| UNK["引用は不明(null)。false として扱わない"]
分母は計測成立のサンプルだけです。成立が 0 件なら言及率は 0% ではなく「無し」にし、0% と「測れていない」を同じ数字で出しません。判定材料はエンジンごとに別物です。HTTP 200 でも検索が失敗していることがあるエンジンでは結果の型(配列か単一オブジェクトか)で分け、空の配列は「0 件で正常」でありエラーではありません。引用元が転送 URL で返るエンジンでは、ホスト名を素直に取ると全件同じ値になります。公式に説明のある項目だけを読み、読めなければ「不明」にします。
ただし LLMO を対象にするときは、計測不成立のサンプルを捨てず、別の指標として数えます。検索が走らなかった回答は、モデルが学習で持っている知識だけで答えたものです。「検索したうえでの言及率」(GEO の指標)とは分母も意味も違うので、「知識での言及率」として別の列に置き、2 つを足しません。検索の機能を渡さずに同じ質問を投げれば、知識だけの回答を毎回確実に取れます。定点計測には、検索ありと検索なしの 2 通りを入れておくと、GEO と LLMO を同じ質問の一覧で追えます。
エンジン間で足さない・比べない、アプリ名を主語にしない
課金の単位(クエリ・呼び出し・検索)も引用の定義も地域指定の可否も揃っていません。だからエンジン間の合算も比較もしません。スナップショットはエンジンごとに 1 行、画面もタブで 1 エンジンずつです。「引用された」と「参照された」も別で、参照した URL は引用より多いと公式に書くエンジンがあります。
測っているのは各社の API の回答です。消費者向けアプリの回答と一致するとは、3 社とも公式に書いていません。だから「ChatGPT での言及率」のようにアプリ名を主語にせず、常設の但し書きを出します。回答は同じ質問でも毎回変わりうる(決定的だと書いた公式もない)ので、1 回の結果ではなく推移で読み、計測日時と、どのモデルにどのブランド語で測ったかをスナップショットに残します。既定のモデルは後から変わります。これが無いと、過去の数字が何を測ったものか分からなくなります。
もう 1 つ必ず残すのが、モデルが実際に投げた検索クエリです。言及が減ったとき、露出が落ちたのか、AI が別の言葉で調べただけなのか。これが無いと永久に切り分けられません。同時にこの検索語は「サイトに何が無いか」の直接の手掛かりでもあります。言及されなかったサンプルの検索語を語句のまま並べ、その語で調べた人が求める答えが 1 段落で置いてあるページがあるかを実測して、ギャップ表と追記文面まで落とします。言及率のレポートで終えないことです。
定点にする——クエリは登録済み、鍵は案件、実費は人が押したときだけ
定点観測の基準はクエリの文言です。実行ごとに AI にクエリを作らせると、伸びたのが露出なのかクエリなのか読めなくなります。未登録なら計測せず登録の案内を返し、見つかった検索語を足すときも既存の文言は変えず、新しいクエリとして足します。10〜20 本が実務上限で、1 回の計測はクエリ数 × エンジン数だけ課金されます。鍵は案件のものを使い、サーバーの実行用の鍵で代用しません。代用すると、利用者が押すたびに運営側へ課金されます。同じ理由で、全案件を回る横断バッチにも載せません。走るのは人が押したときと、監査の実行が求めたときだけ。後者には再計測の最短間隔(1 日 1 回)を 1 箇所で持たせ、定期実行に載った監査が毎日課金しないようにします。画面の「計測する」ボタンにはこの間隔を掛けません。あちらは人が押した 1 回だからです。
計測の基準になるクエリは、次のようにファイルに定義して保存します。温泉旅館の例です。
brand_terms:          # 表記ゆれは 1 行 1 件。判定は大文字小文字だけを畳んだ部分一致
  - 山の湯旅館
  - やまのゆ旅館
  - Yamanoyu Ryokan
own_domains:
  - yamanoyu.example.jp
competitors:          # 言及を数える競合は 5 社まで
  - A 旅館
  - B ホテル
queries:              # 文言は変えない。変えたいときは新しい id で足す
  - id: q01
    type: 指名
    text: 山の湯旅館はどんな宿ですか
    added: 2026-07-01
  - id: q02
    type: おすすめ
    text: 子連れで泊まりやすい温泉旅館を教えてください
    added: 2026-07-01
  - id: q03
    type: 比較
    text: 山の湯旅館とA旅館の違いは何ですか
    added: 2026-07-01
  - id: q04
    type: 地域・用途
    text: 駅から送迎があって、露天風呂付きの部屋がある温泉旅館は
    added: 2026-08-01
    retired: 2026-09-01   # 行は消さず、計測だけやめる。月ごとの比較は両方の月で測った id だけで行う
クエリは、指名(ブランド名で聞く)・おすすめ・比較・地域や用途の 4 種類に分け、合計 10〜20 本にします。文言は、実際の問い合わせや予約の電話で聞かれた言い方から取ります。キーワードの一覧を質問の形に書き換えただけでは、お客さまが AI に打ち込む聞き方になりません。
計測した結果から打ち手を出してもらうときは、次のように頼みます。前の節の「言及されなかった」と「検索されなかった」の区別を、依頼文の側でも指定しています。
先月の計測結果(添付)から、サイトに足すべき内容を洗い出してください。

- 対象は「検索が実行され、当館が言及されなかった」サンプルだけです。
  検索が実行されなかったサンプルは除き、その件数を冒頭に書いてください
- 各サンプルについて、モデルが実際に投げた検索語を語句のまま並べてください
- その検索語で調べた人が求める答えが、当館のサイトに 1 段落で書かれたページがあるかを
  実際にページを読んで確かめ、「ある(URL)/ ない」で答えてください
- 「ない」ものには、追記する文面の案を 200 字程度で付けてください
- エンジンごとに分けて書き、エンジン間で言及率を足したり比べたりしないでください
- 「ChatGPT での言及率」のようにアプリ名を主語にせず、API で測った結果だと書いてください
筆者の環境では、クエリとブランド語を登録して「計測する」を押すと、鍵を登録したエンジンにだけ質問が投げられます。結果は 1 件ずつ、投げた質問・自社の言及・自社サイトの引用・競合の言及・モデルが実際に検索した語が並びます。集計した言及率より、この 1 件ずつの行のほうが打ち手に直結します。監査の実行から測ったときも、その日 2 回目からは記録済みの結果を使います。
鍵が 1 つも無い案件で「直近に計測済み」と返してはいけません。測れるエンジンの集合と、新しく鍵を足したエンジンの集合を混ぜると、一度も測っていないのに測ったことになります。「測れない」と「測った」は、どんな理由があっても混ぜません。
章のまとめ
- SEO は 5 つの領域に分けて自動化する。監査は 1 つの入口から委譲し、入口を増やさない。
- 連携の作法は「クライアントは 1 つ・コールバックは 1 本・スコープは機能ごと・保存は実際の付与内容」。サービスアカウントの鍵だけでは読めない。
- 「鍵がある」と「読める」は別。接続状態は叩いた結果から作る。テスト状態のトークンは 7 日で切れる。
- 単位は経路ごとに確定させる。GSC の CTR は 0〜1 で、推測分岐は 100 倍の誤りを生む。
- 平均掲載順位もキーワードプランナーの数字も順位ではない。実測はブラウザが要るのでジョブで動かし、縮退したら経路を記録する。
- 記事は正本から生成し、一次情報を取材で入れ、下書きで止める。書く材料はネットで調べた情報ではなく、社内のノウハウと実績から取る。SEO でも LLMO でも同じ。サイトマップ・インデックス送信は承認を通す。
- 機械的な提案と定点計測に生成 AI を使わない。同じ入力から同じ結果を出す。
- コンテンツの質は E-E-A-T と Who / How / Why で点検する。AI 向けには、E-T-R(根拠・追跡性・定着性)の観点で補って点検できるが、Google の用語ではないので所見は分けて出す。最も重要なのは信頼性で、権威性と信頼性は記事の書き方では変わらない。書く前に、ページの種類が検索結果と合っているかを確かめ、キーワードは検索結果の重なりでまとめる。
- AIO は Google の AI 機能、GEO は検索して答える AI 全般、LLMO はモデルの知識までを含む。呼び名ではなく「どの AI の、どの回答で、何を測るか」を書く。
- AI は質問を複数の検索語に分けて調べる(クエリファンアウト)。分かれた検索語ごとに答える段落をサイトに持つ。段落の選ばれ方はコサイン類似度で近似できるが、値は同じモデルでの比較にだけ使う。
- LLMO は「検索されなかった」と「言及されなかった」を分け、エンジン間で足さず、アプリ名を主語にしない。検索なしの回答は、知識の指標として別に数える。
- 被リンクは情報源ごとに確かさが違う。要因が揃わなければ点数を出さず、否認は手動による対策が絡むときだけ検討する。
- canonical・noindex・商品の構造化データは最初の HTML で返す。多言語ページは自分自身と相互の指定をそろえ、翻訳の中身まで確かめる。
- 改善は、ベースライン → 施策の一覧 → 実行 → 決めた日の読み戻し、の周期で回す。効いたと言えない結果は「確かめられない」として分ける。
演習
- 自社サイトの Search Console から、クエリ×ページの実績を 28 日分取り、「あと一歩」「クリック率」「順位下落」の 3 つの条件で候補を出してみてください。CTR の単位を確かめてから始めること。
- 記事を 1 本、上位 10 件の見出し分析 → 取材 → 下書き入稿の順で作り、どの工程が自動化でき、どの工程を人に残すべきかを書き出してください。
- お客さまが AI に打ちそうな質問を 10 本決め、いずれかの API で投げて、検索が実行されたか・言及されたか・引用されたか・モデルが投げた検索語、の 4 つを記録する表を作ってください。
- 狙っているキーワードを 1 つ選び、上位 10 件を 11 種類に分類して、自社のページの種類が合っているかを確かめてください。あわせて、そのページを E-E-A-T の 4 要素で点検し、所見ごとに「記事で直せるか、サイト運営や広報の仕事か」を書き分けてください。
- 演習 3 の質問から 1 本選び、AI が分けて調べそうな検索語を 10 個予測してください。そのうえで、自社サイトの段落とのコサイン類似度を埋め込み API で計算し、答える段落が無い検索語を挙げてください。最後に、演習 3 で記録した「モデルが投げた検索語」と予測を比べてください。
- 自社サイトのサイトマップを取得し、200 以外の URL・noindex・canonical が別の URL・転送される URL が含まれていないかを確かめてください。あわせて、トップページの最初の HTML と描画後の HTML で、title・canonical・robots の指定が同じかを比べてください。
- 演習 1 の候補から 1 つ選び、施策の一覧の 1 行(優先度・依存・ベースライン・失敗の判定)を書いてください。読み戻す日を決め、その日に結果と判断を記録してください。
次の章へ
次の第 7 章「アカウント運用を自動化する(前編:自分のアカウントを回す)」では、Instagram や TikTok の投稿設計と予約投稿の API 化、トークンの寿命、合算してはいけない数字を扱います。